NVIDIA RTX Spark N1X: Blackwell, ARM y hasta 128 GB de memoria unificada, ¿IA local DEFINITIVA o una COSTOSA decepción?
- Por Ed Corsa
- 18 min de lectura
NVIDIA entra de lleno al mercado de procesadores para PC con RTX Spark N1X. Su combinación de CPU ARM, GPU Blackwell y hasta 128 GB de memoria unificada promete una nueva alternativa para gaming, creación de contenido e IA local.
Si tienes algunos años metido en tecnología y mas precisamente en el tema de GAMING en PC, sabes bien que NVIDIA ha dominado una parte muy importante del mercado de aceleración gráfica para computadoras personales, estaciones de trabajo y centros de datos. Sin embargo, con los nuevos RTX Spark la compañía está buscando algo más ambicioso: meter su cuchara directamente en el mercado de plataformas de cómputo para Windows, combinando sus tecnologías gráficas con procesadores ARM y una arquitectura de memoria unificada que puede alcanzar los 128 GB, un producto con mucho potencial dadas sus caracteristicas, tanto para revolucionar la industria, como tambien para ser OTRO intento fallido de Windows en ARM, esto ultimo, solo el tiempo y el soporte lo decidirá.
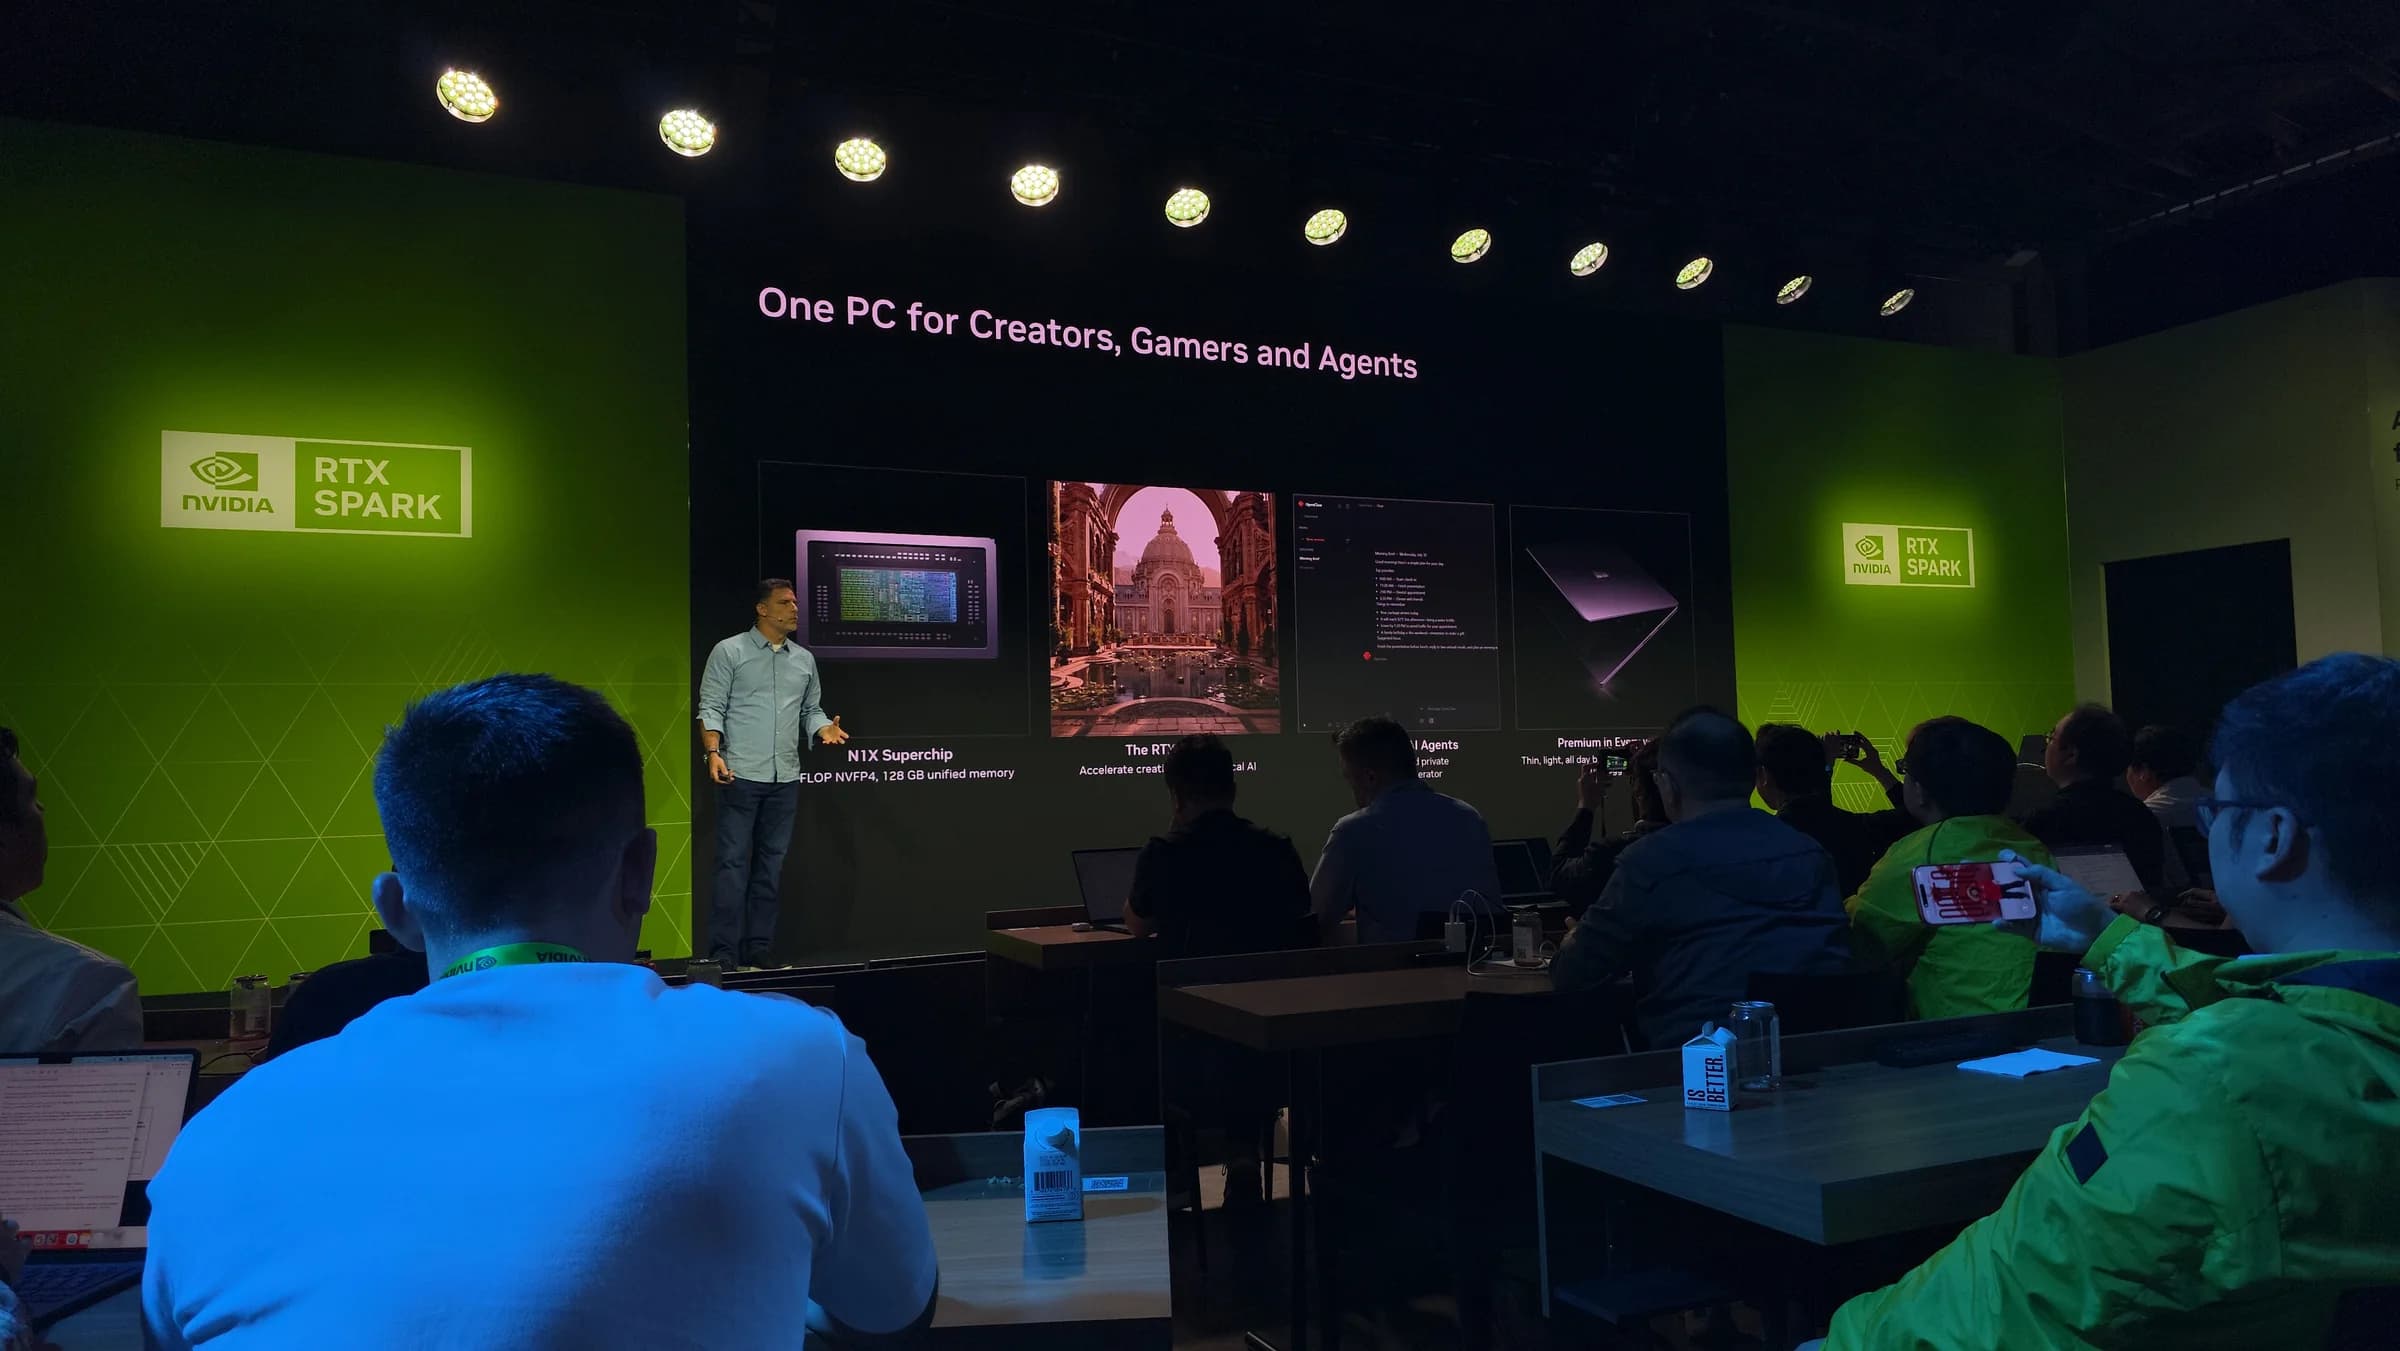
La propuesta gira alrededor del NVIDIA N1X, un SoC desarrollado en colaboración con MediaTek que combina núcleos de CPU ARM con una GPU basada en la arquitectura Blackwell. El resultado es una plataforma diseñada para laptops relativamente delgadas y computadoras de escritorio compactas, con capacidades de aceleración gráfica, creación de contenido y ejecución de modelos avanzados de inteligencia artificial, que en papel, suena muy bien, sobre todo cuando tomamos en cuenta las limitantes artificiales que mismo NVIDIA ha puesto en el acceso a VRAM en sus tarjetas graficas dedicadas de la familia GeForce, y que parece que con esta arquitectura unificada tipo consola de videojuegos se puede mitigar un poco.
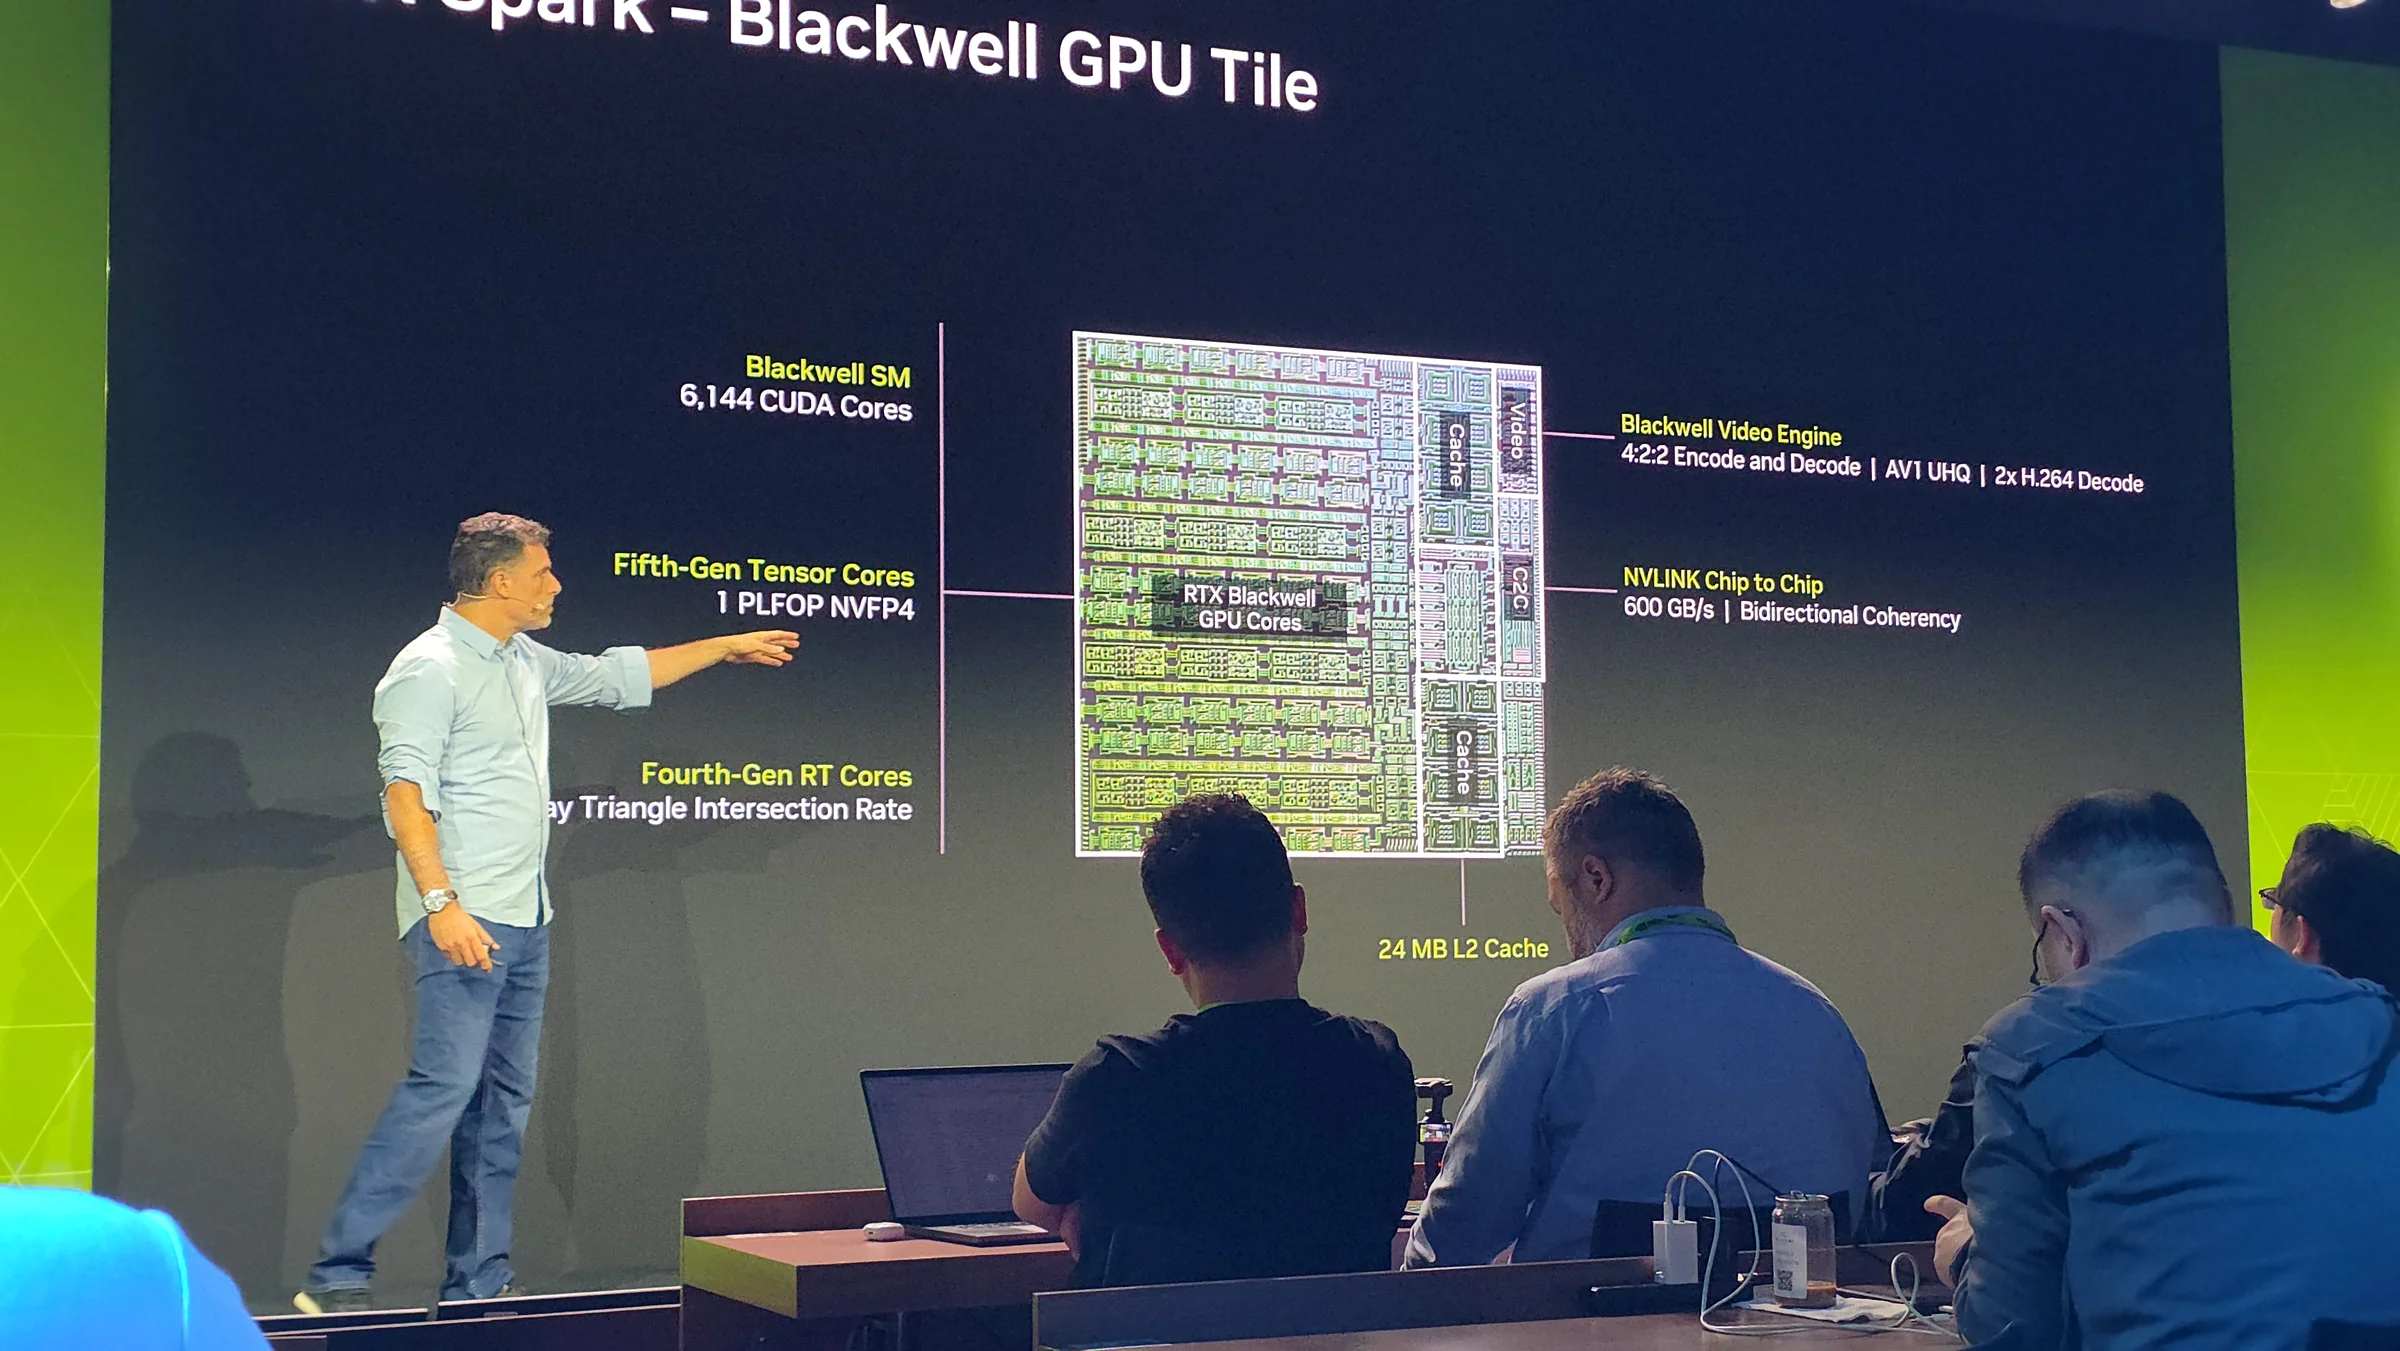
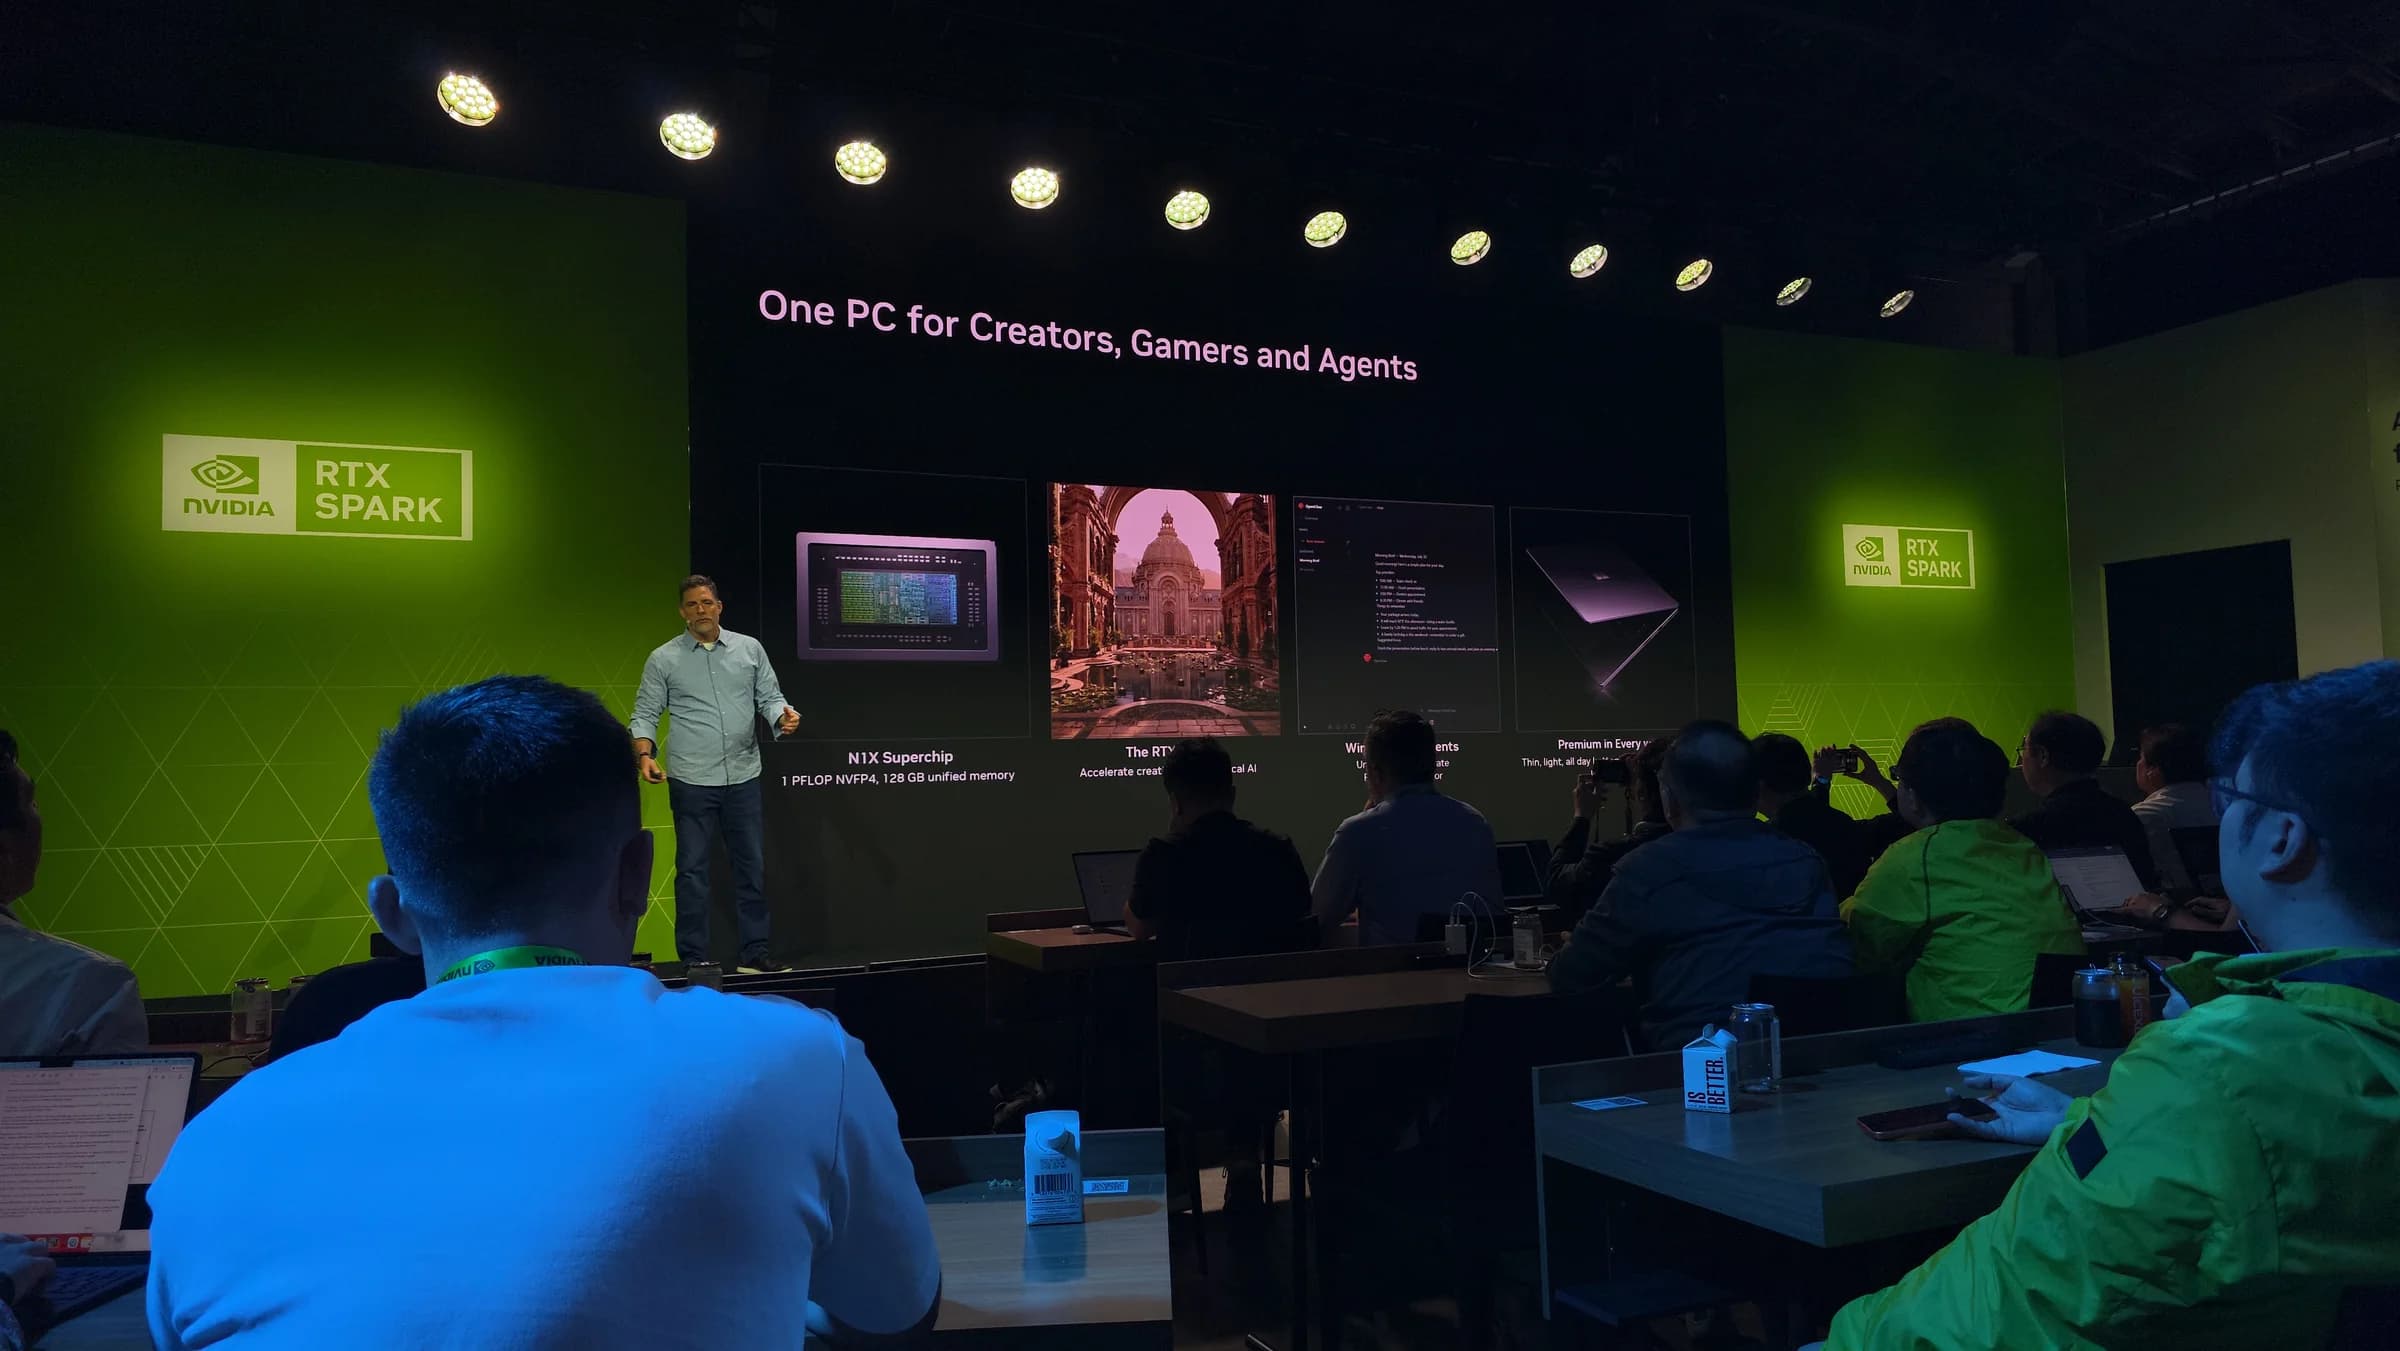
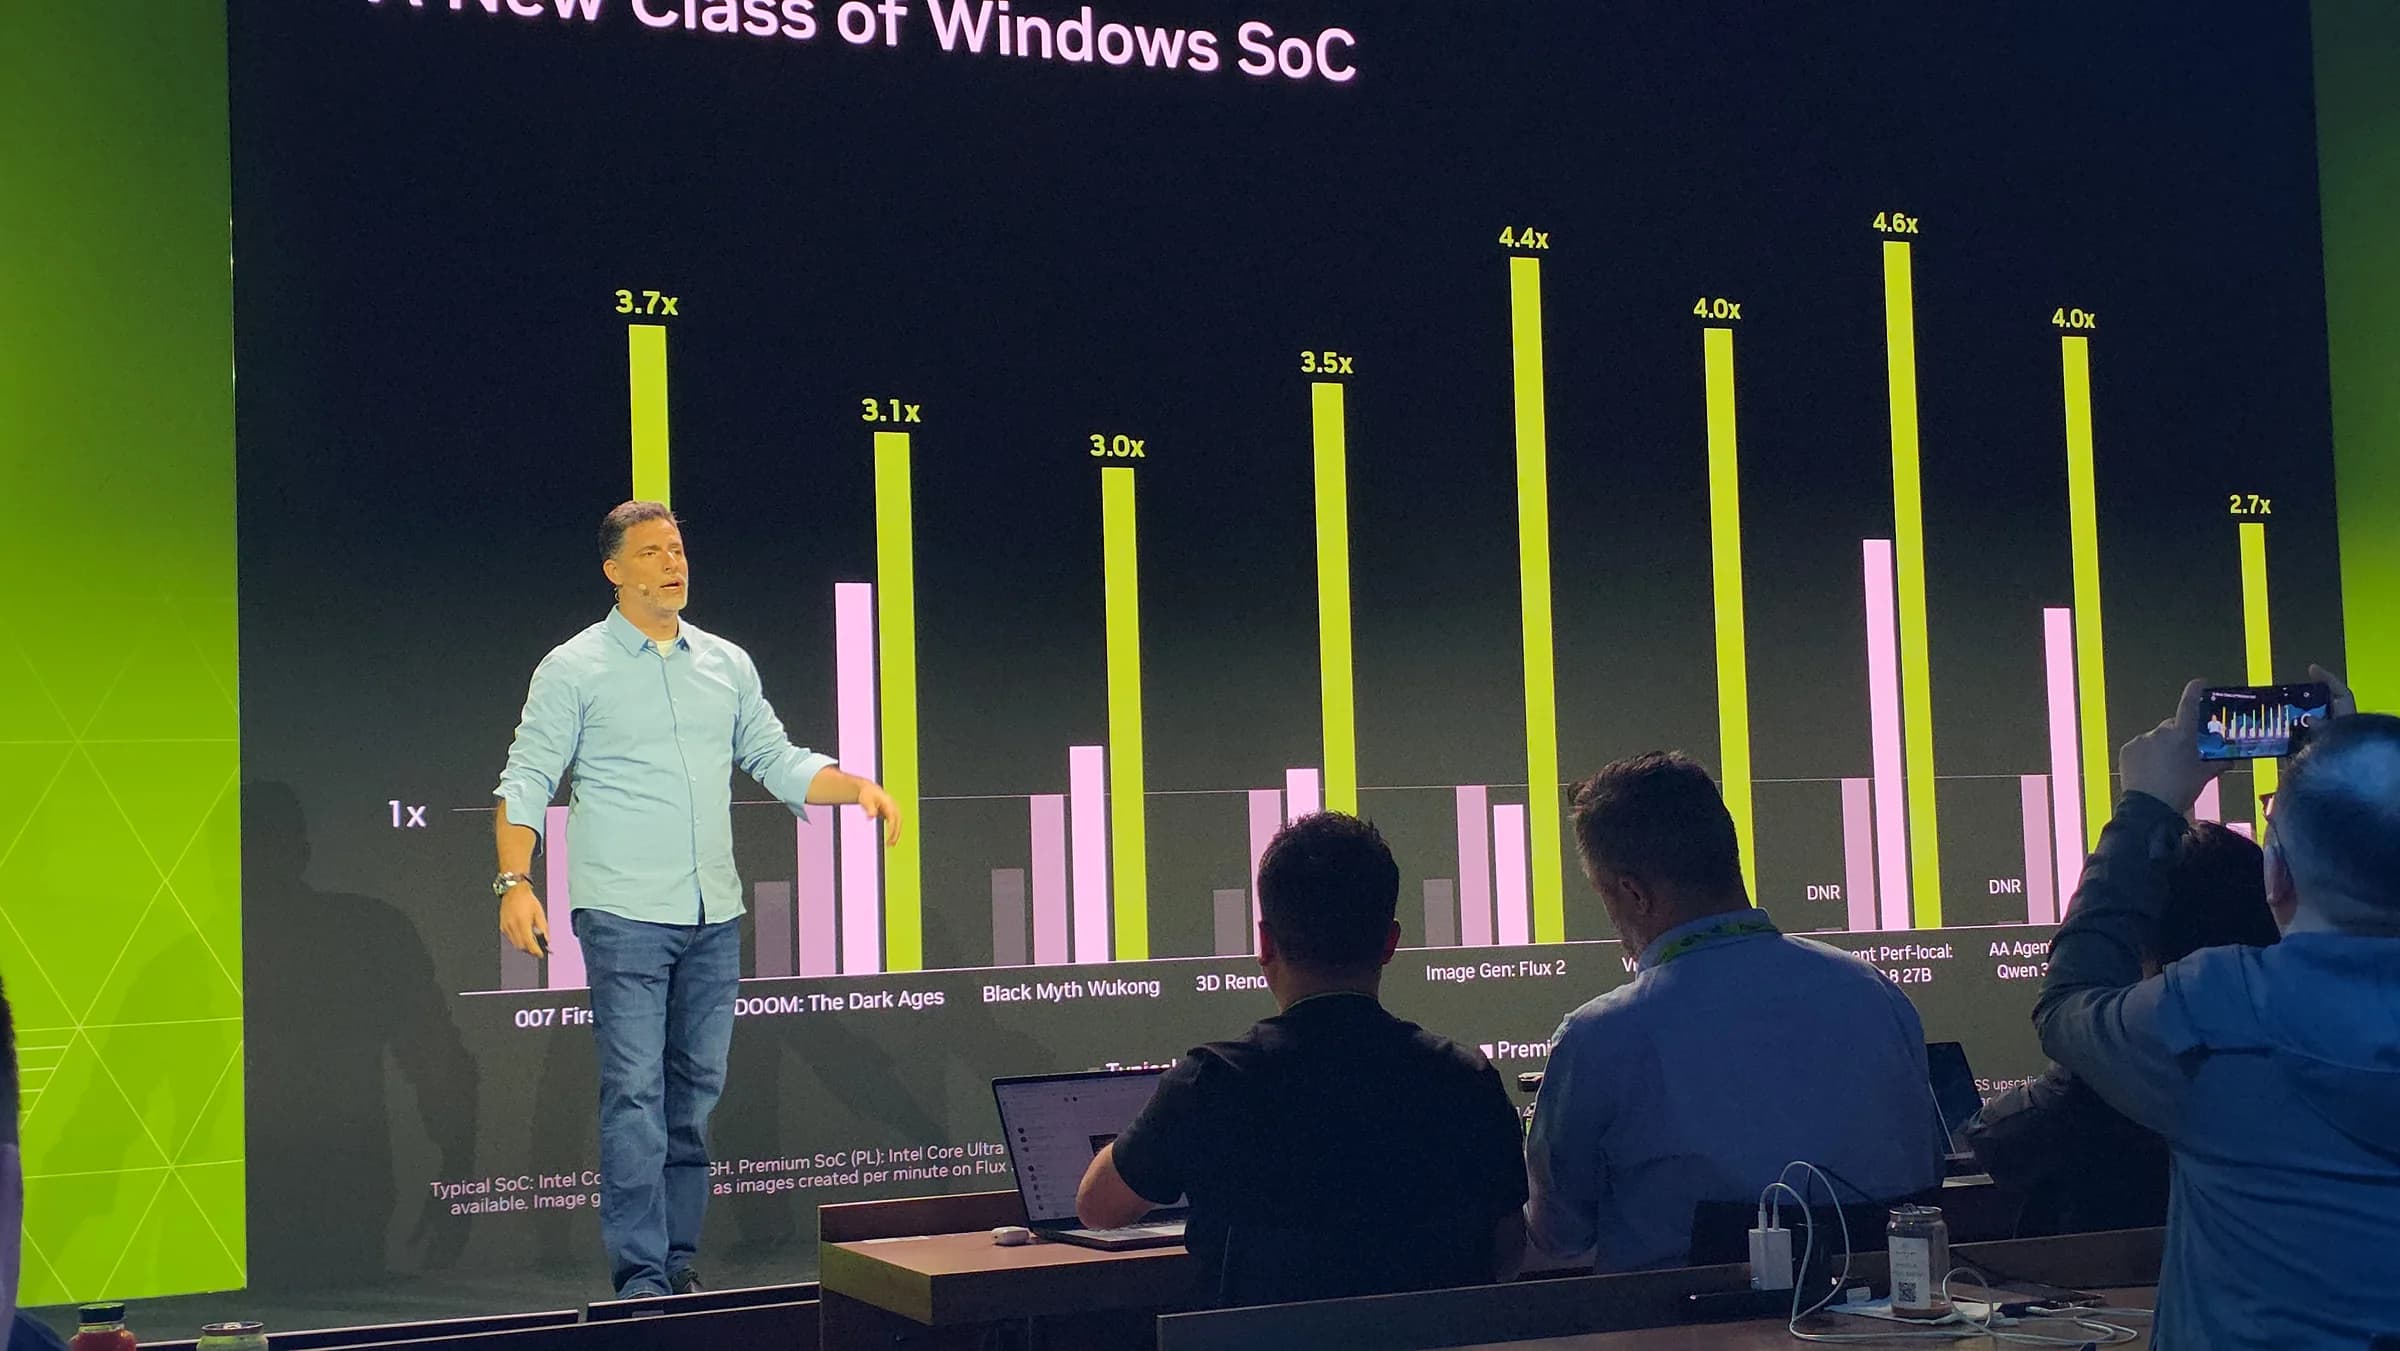
Recientemente tuve el honor de poder asistir al RTX Spark Editor's Day en San Francisco California, y ahú durante la presentación técnica para medios encabezada por Justin Walker, NVIDIA explicó que RTX Spark busca llevar parte de las capacidades tradicionalmente asociadas con estaciones de trabajo a dispositivos de consumo y equipos profesionales portátiles. La compañía también presentó resultados de rendimiento y eficiencia energética que, aunque prometedores, necesitan evaluarse considerando las condiciones particulares de cada prueba. De acuerdo con otros analistas del mercado, DGX spark y RTX Spark son productos que estan saliendo casi dos años tarde al mercado y con hardware que no es tan eficiente energéticamente como se nos quiere hacer creer, asi que hay que proceder con cuidado.
Tambien me resulta muy interesante que NVIDIA no está proponiendo simplemente una GPU dedicada más rápida ni solamente un nuevo procesador para competir con Intel, AMD y Qualcomm, RTX Spark representa un acercamiento diferente al diseño de una PC, al ser un SoC (System on a Chip) tiene ventajas importantes para acceso a memoria y velocidad vs consumo de energía, aunque de igual forma atenta de manera directa a la modularidad del estandar de PC, aunque en laptops la norma sea desde hace mucho que los upgrades representan un cambio completo de sistema. Otra cosa a destacar es que NVIDIA quiere está empujando fuertemente la narrativa de que la capacidad para ejecutar modelos de IA locales comienza a convertirse en un criterio tan importante como el rendimiento tradicional de CPU y GPU.
Blackwell y ARM dentro del mismo paquete
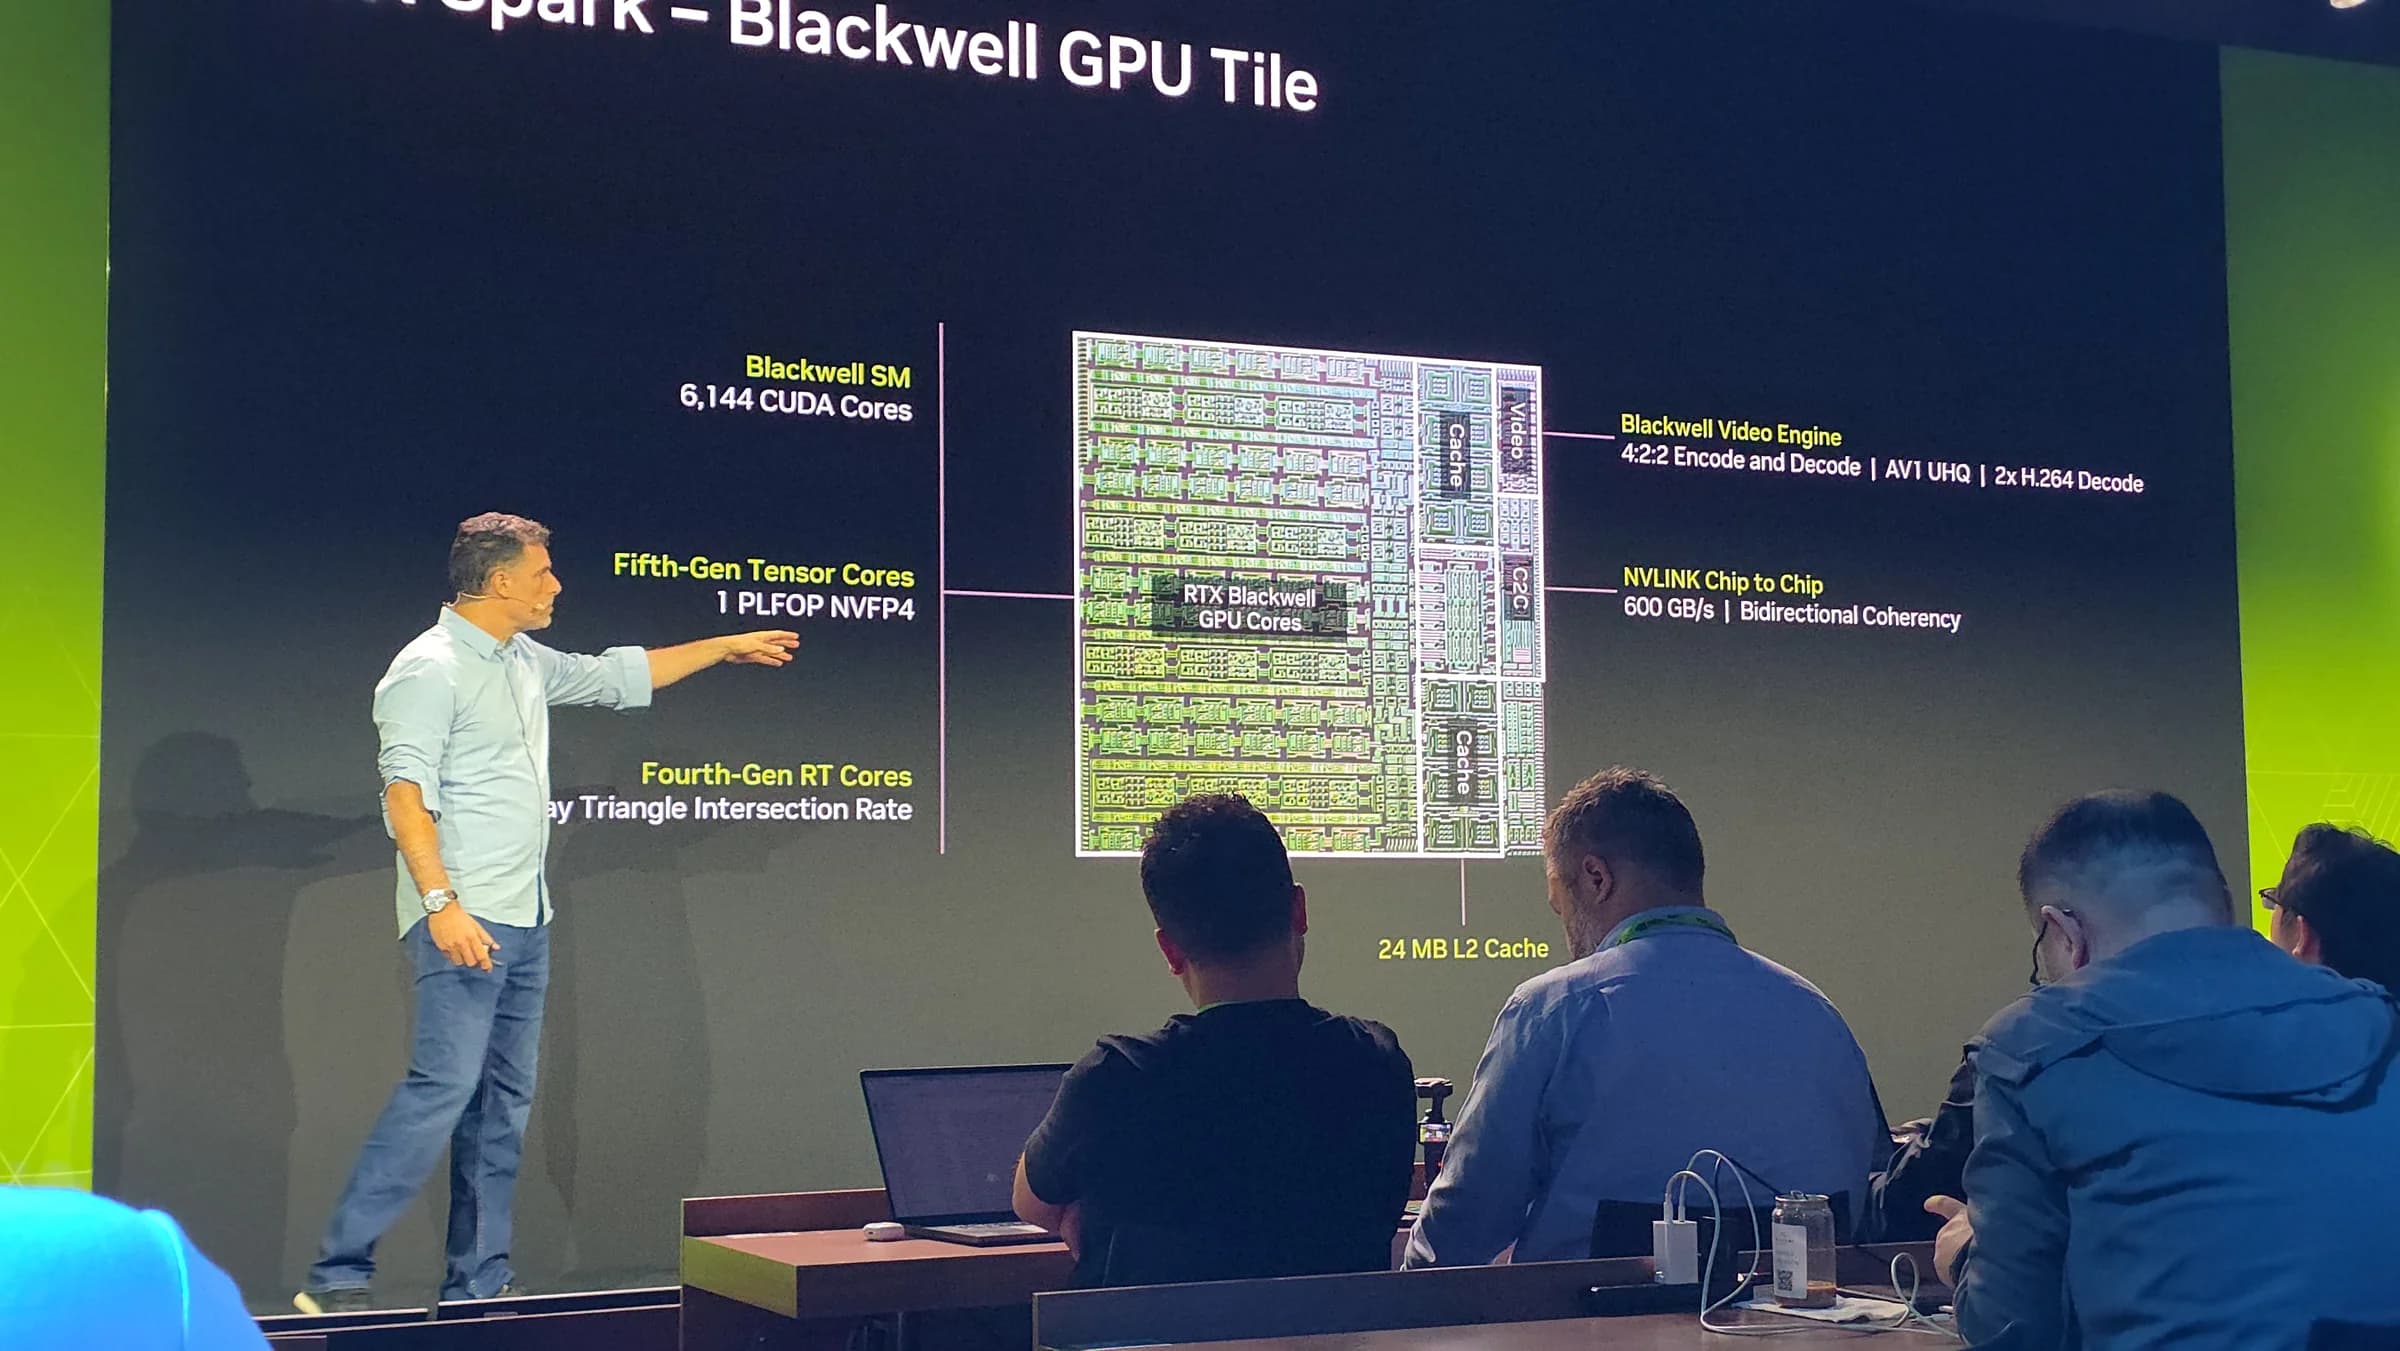
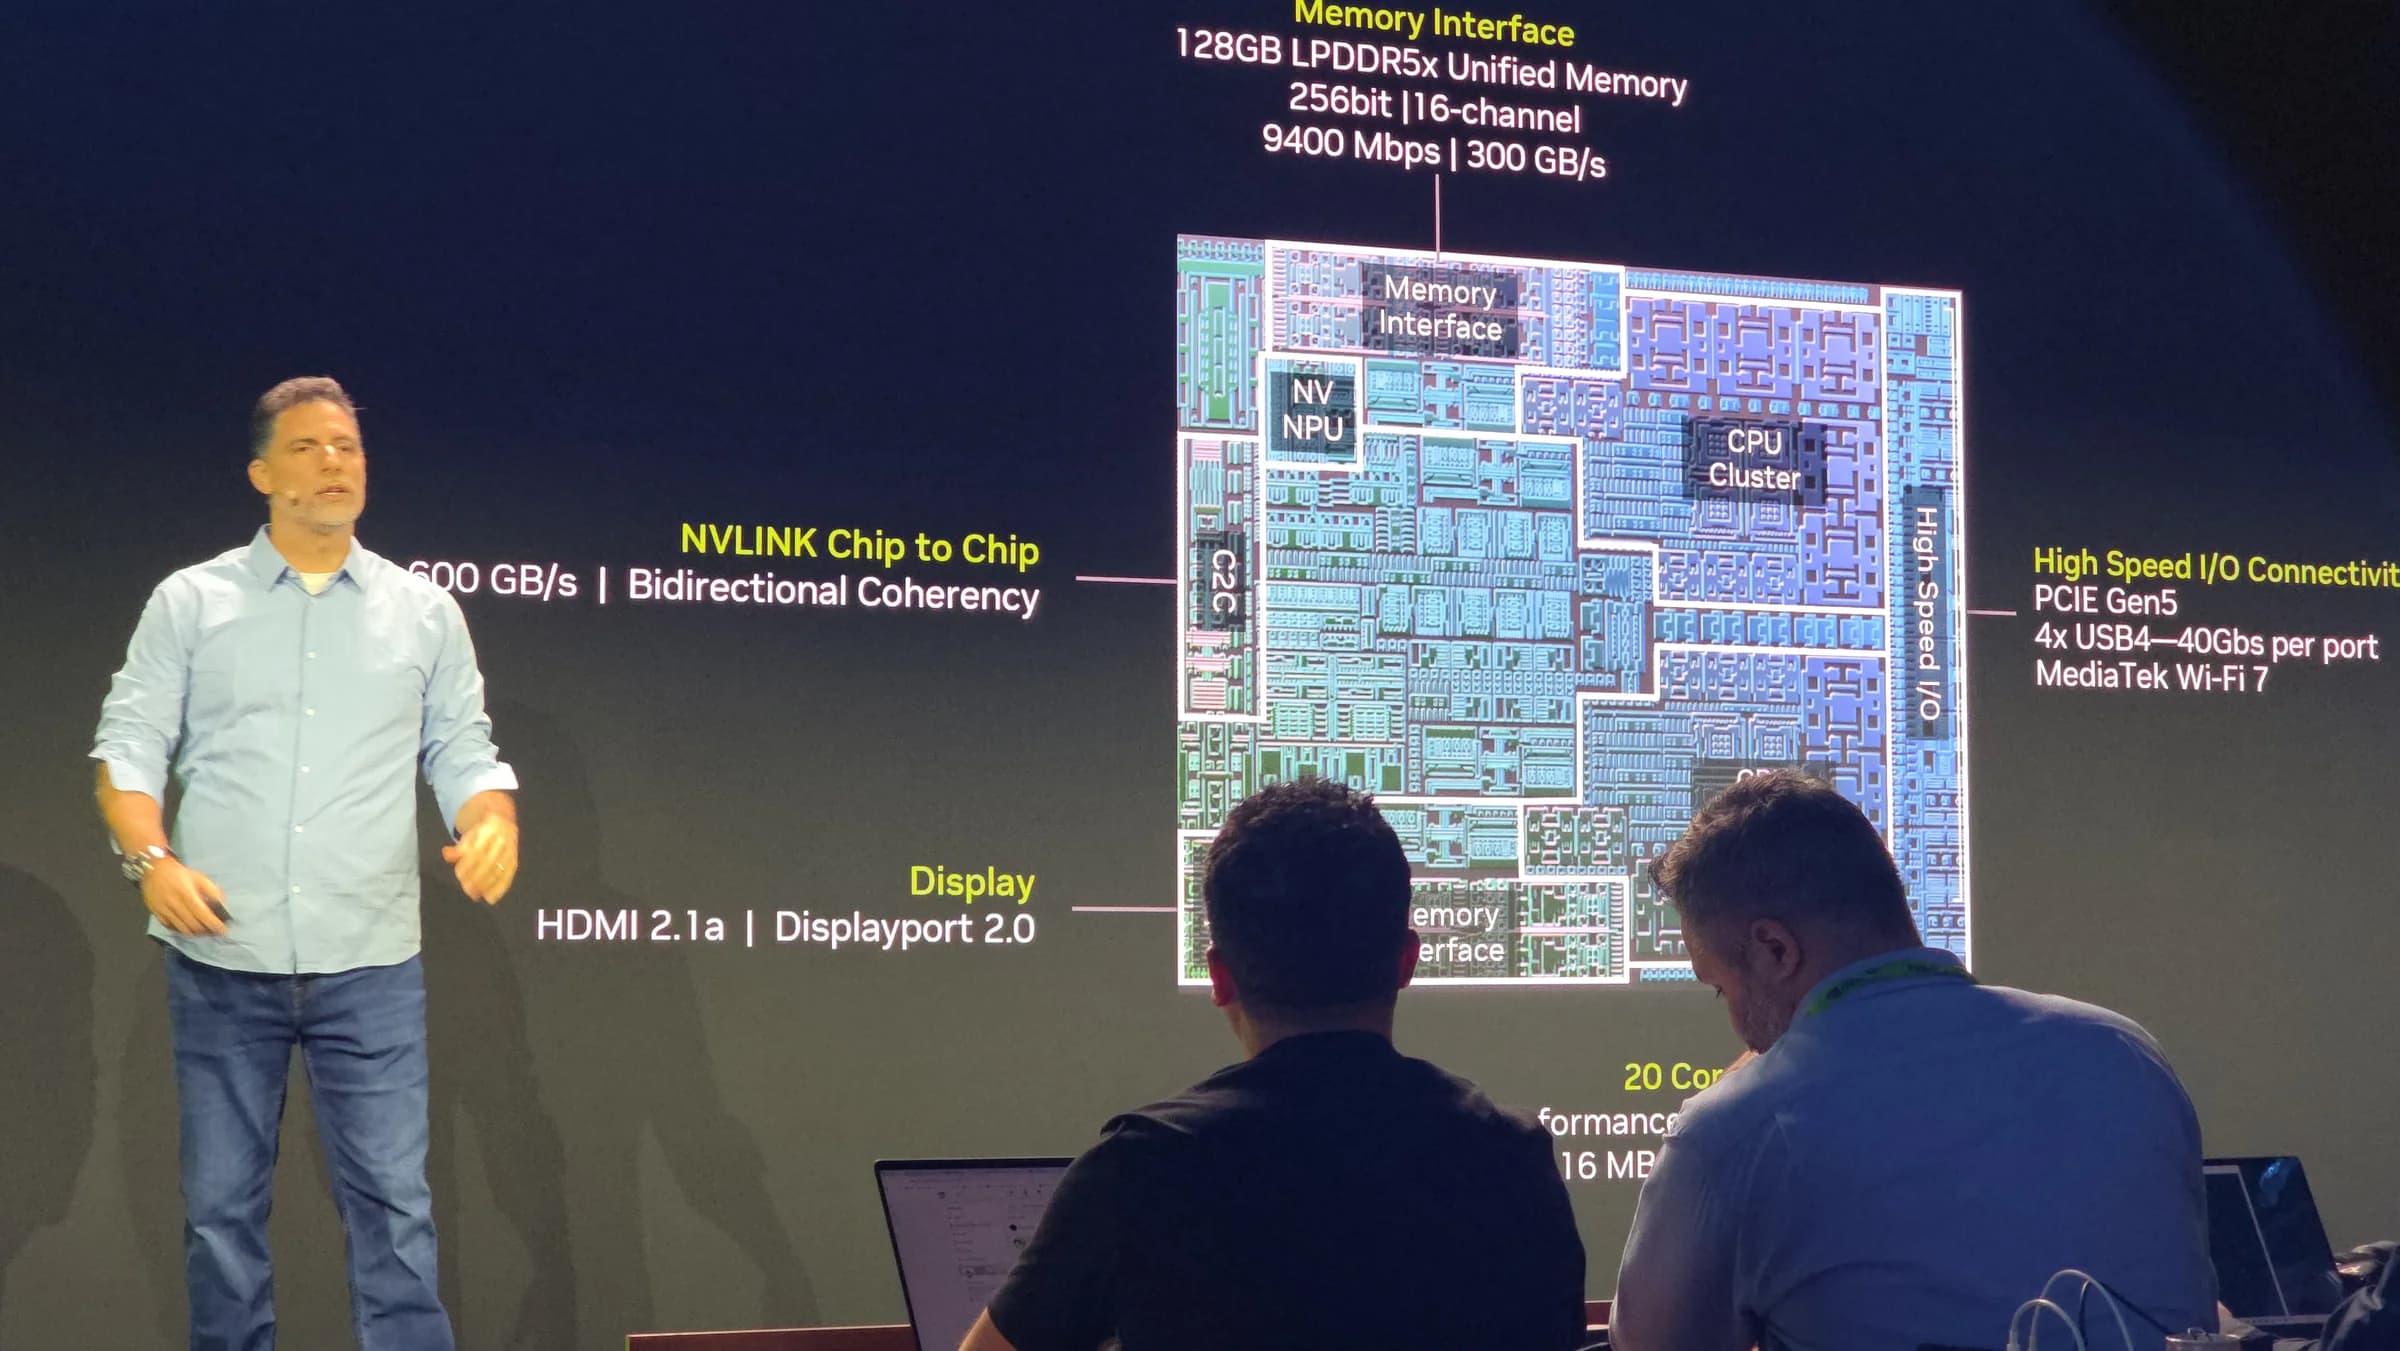
Los sistemas con NVIDIA N1X integran dos componentes principales, uno dedicado al procesamiento gráfico y otro encargado del CPU y las funciones de entrada y salida. Ambos están interconectados mediante NVLink-C2C, una tecnología que permite comunicación de alta velocidad y coherencia de memoria entre los procesadores.
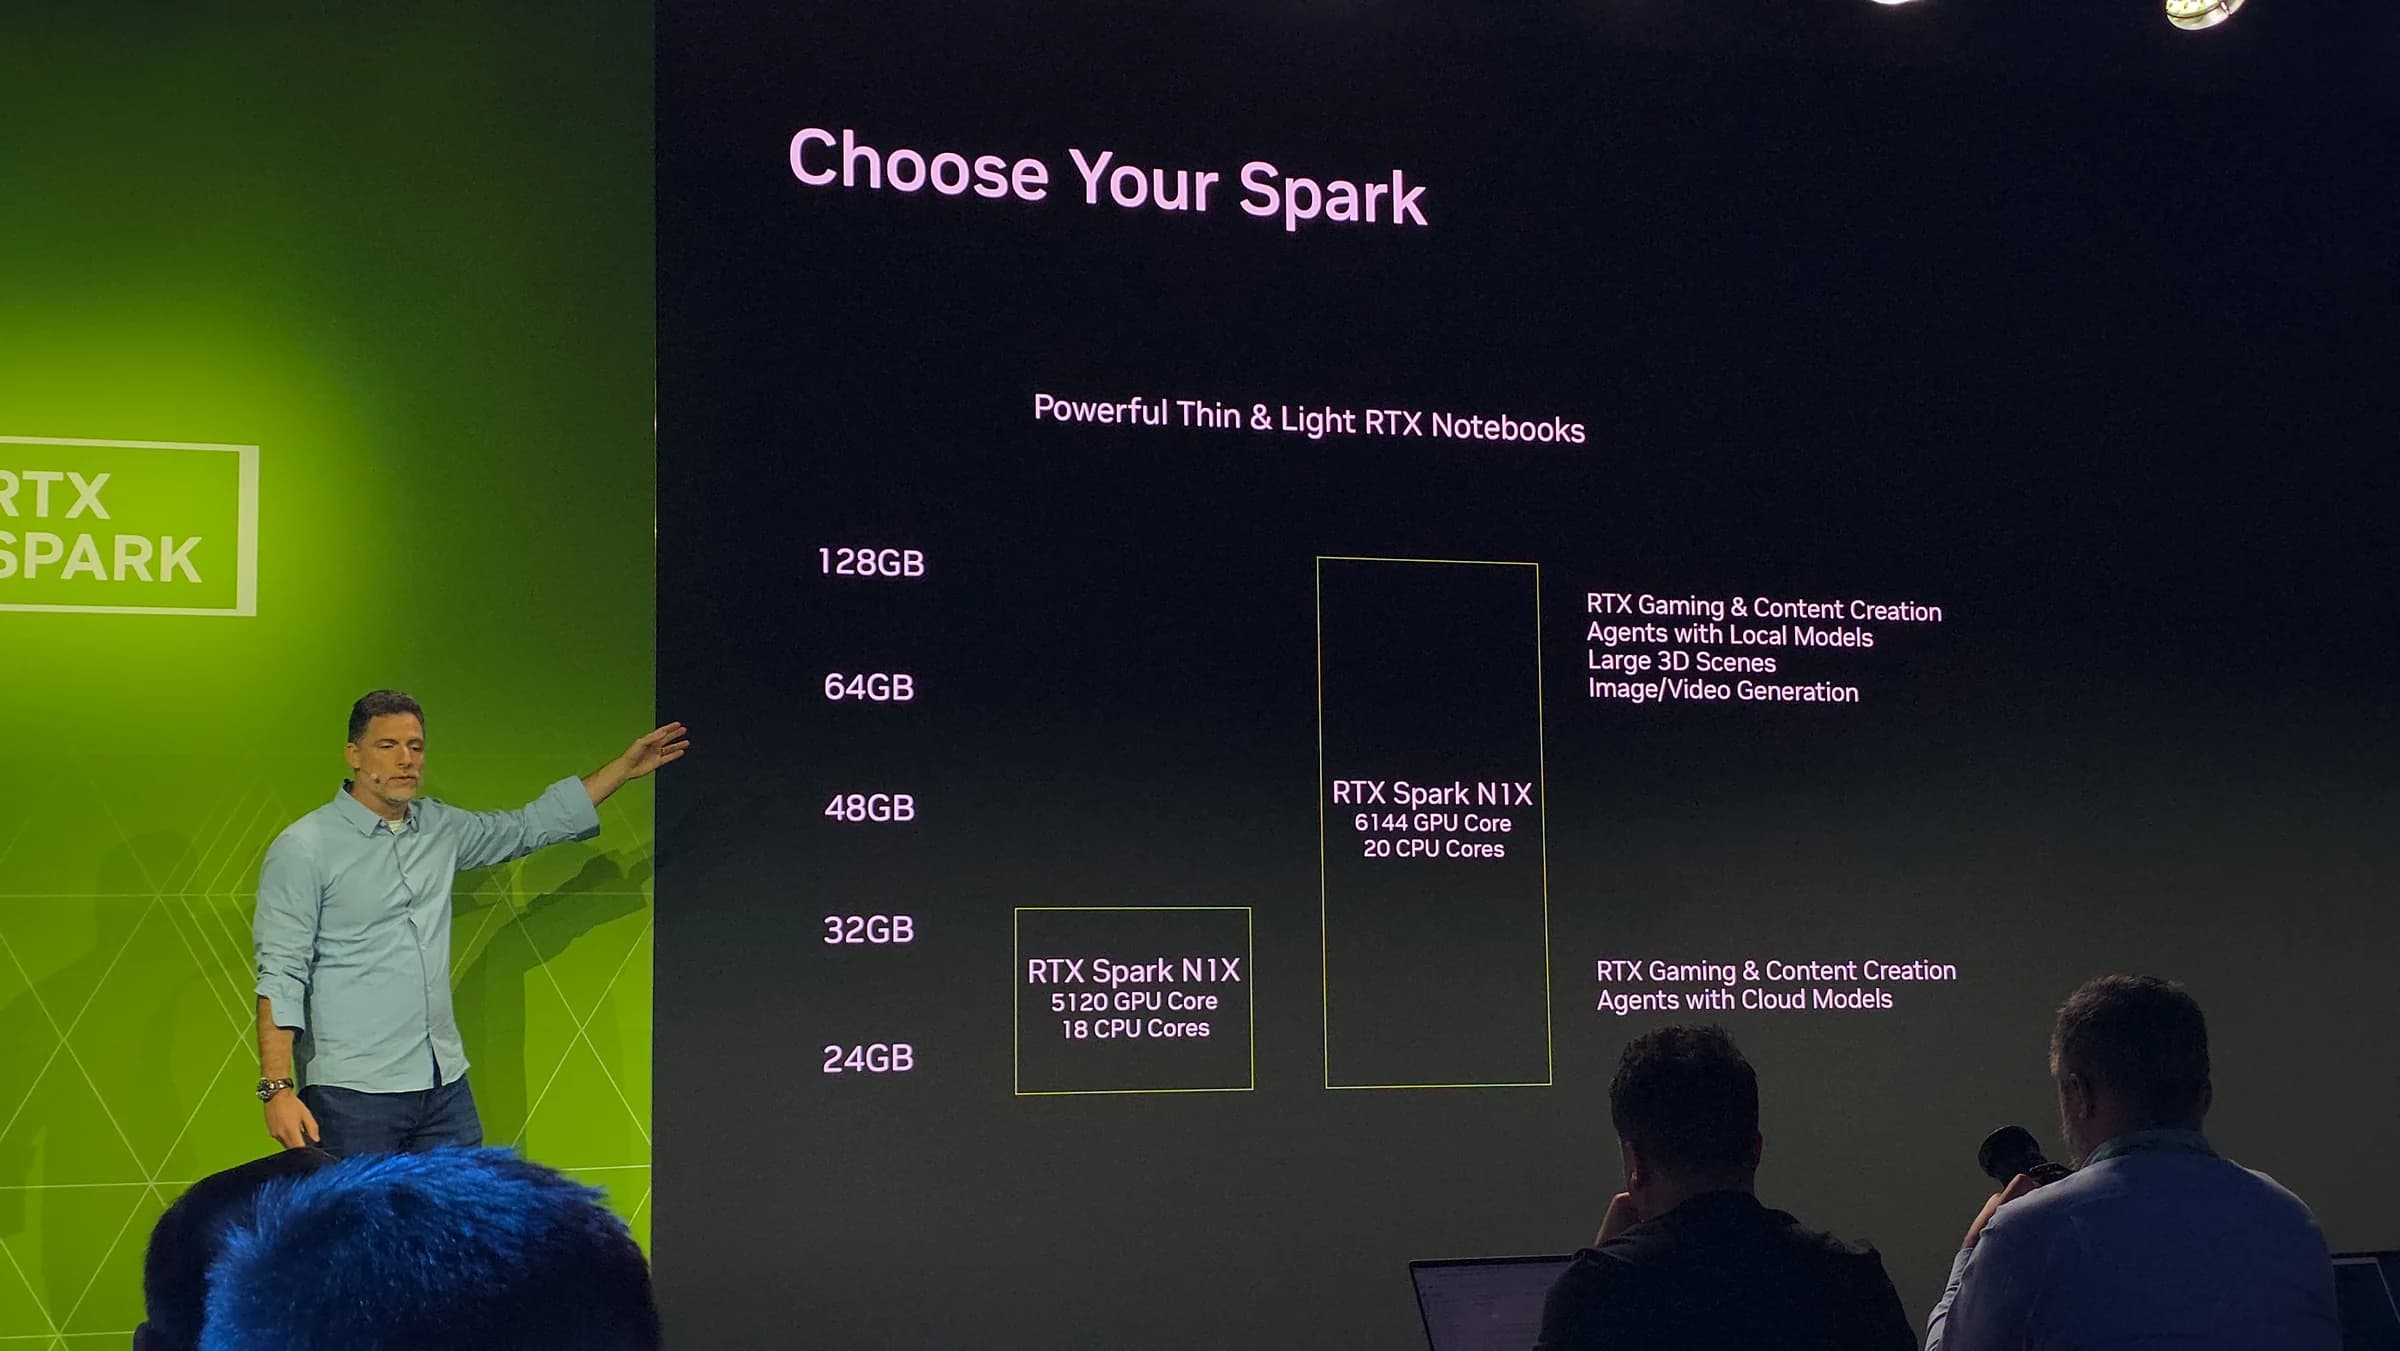
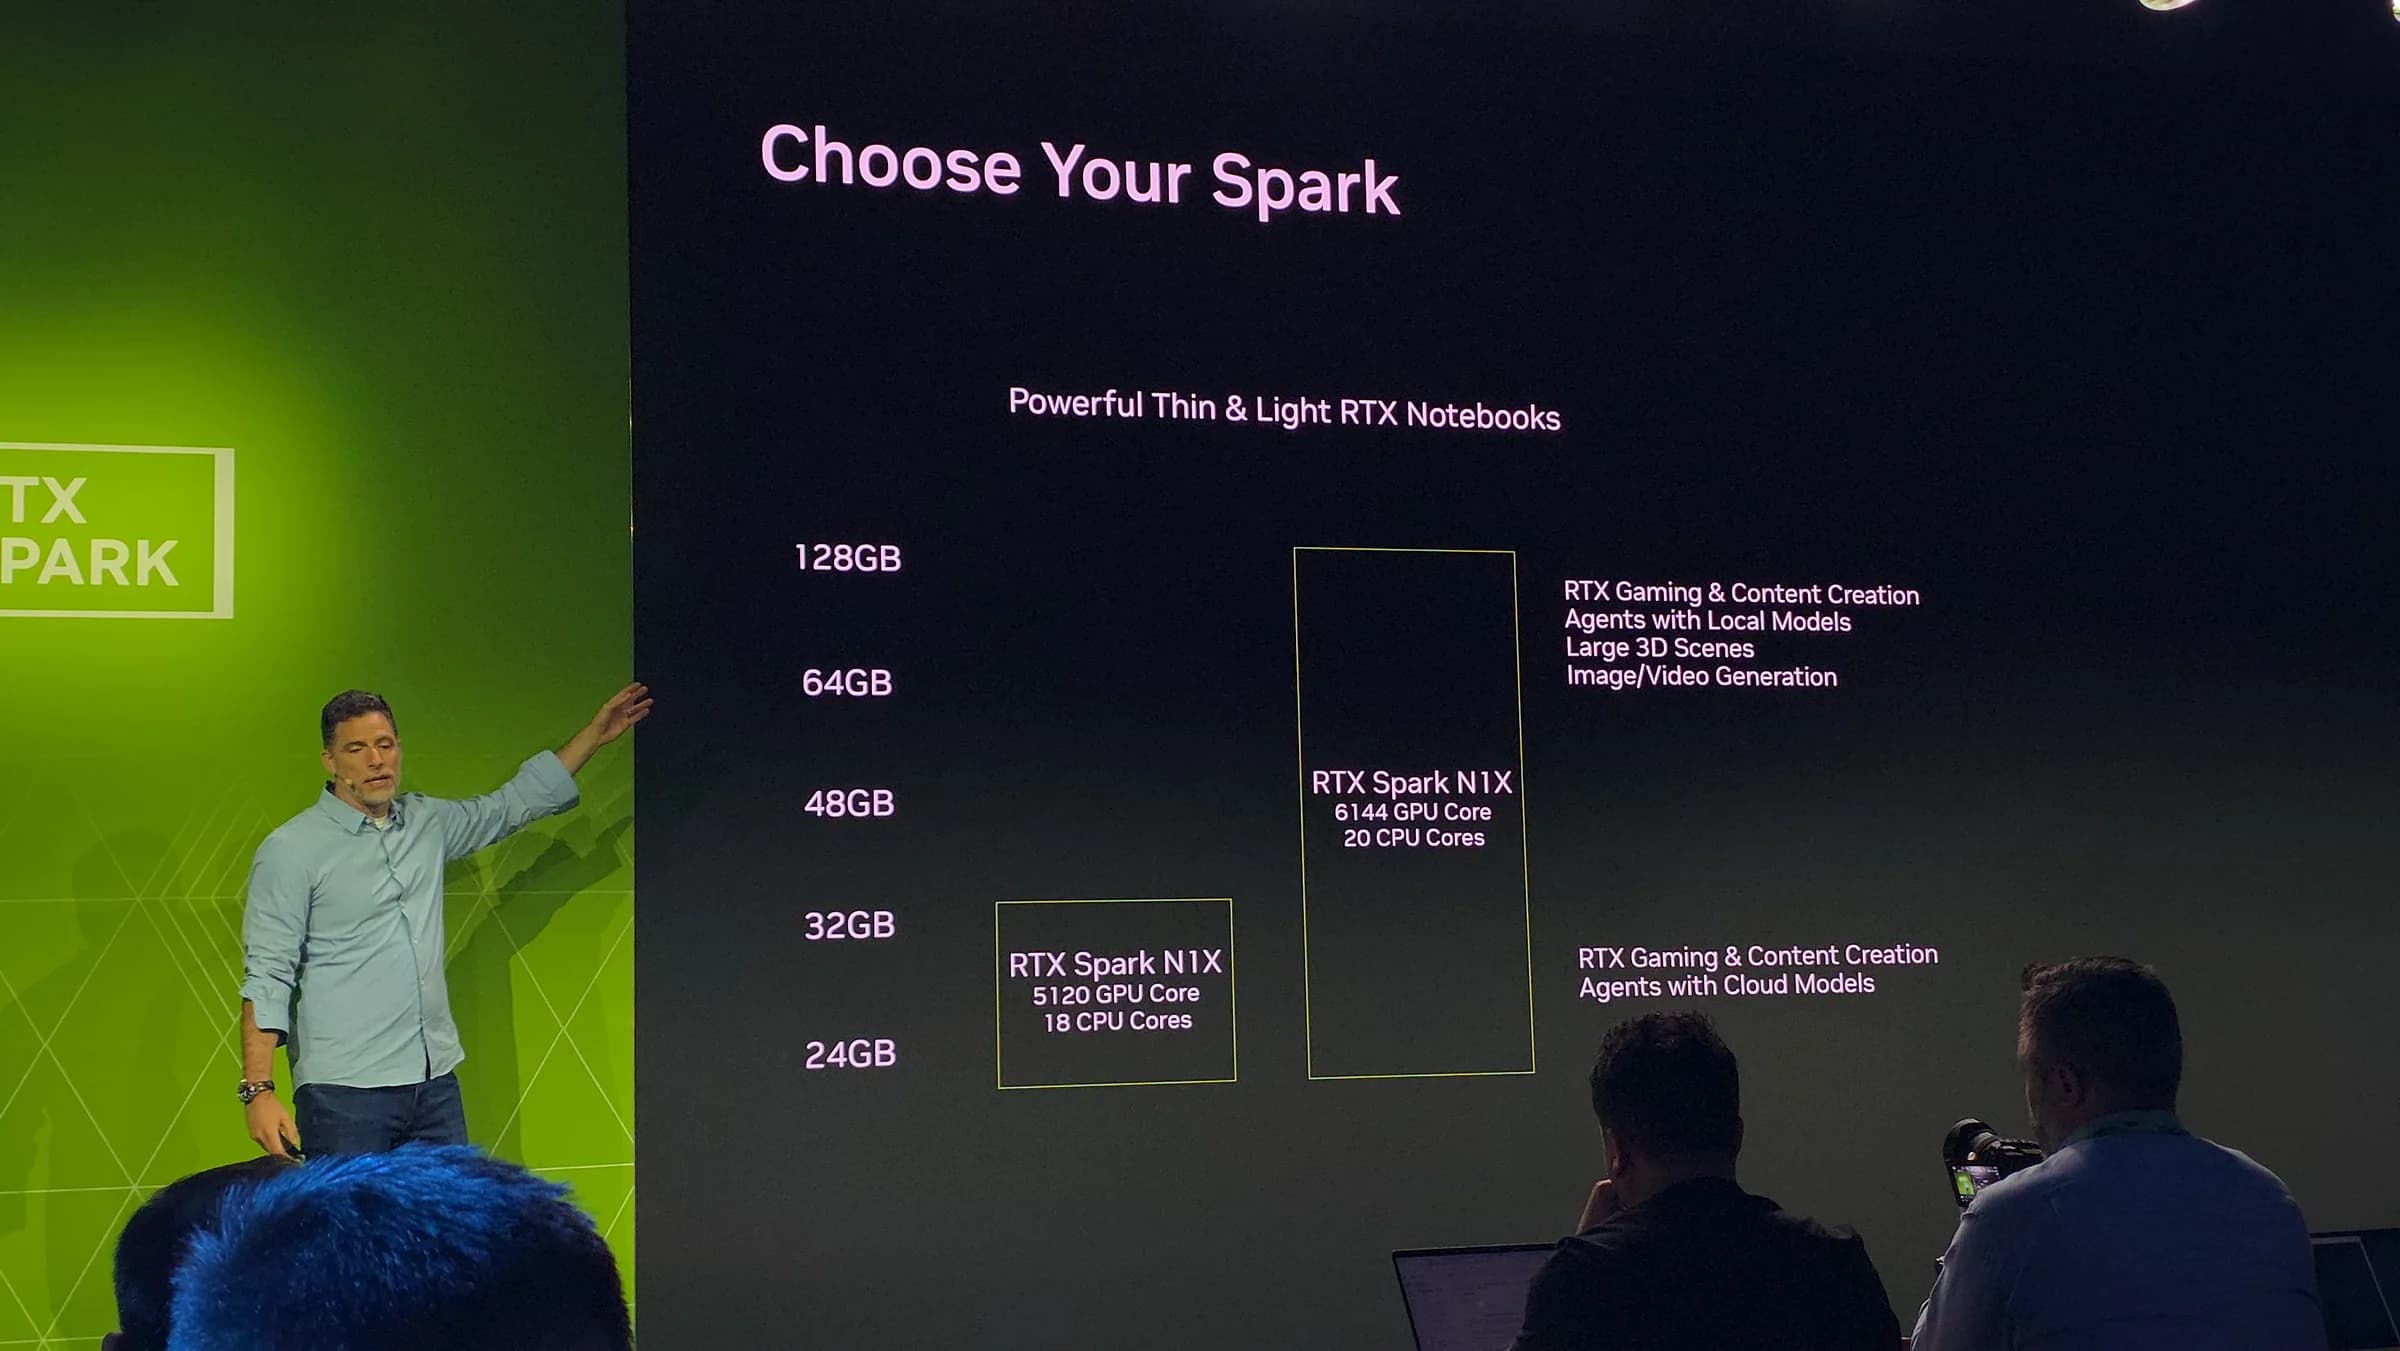
Como el Ying Yang, dentro de todo los bueno hay algo malo y dentro de todo lo bueno hay algo malo, el GPU utiliza arquitectura Blackwell (mas que excelente) y estará disponible en configuraciones de 5,120 y 6,144 CUDA Cores. También incorpora Tensor Cores de quinta generación y RT Cores de cuarta generación, elementos necesarios para acelerar cargas de inteligencia artificial y renderizado mediante ray tracing. Por su parte, el CPU utiliza arquitectura ARM bajo la familia NVIDIA Grace (El negrito en el arroz, del lado de Microsoft Windows, dado que ARM no ha sido particularmente efectivo hasta ahora). Las configuraciones principales para laptops incluyen 18 y 20 núcleos, mientras que durante la presentación también se mencionó una variante de 24 núcleos para sistemas compactos de escritorio.
La configuración de 20 núcleos se describió con una distribución de 10 núcleos de alto rendimiento y 10 núcleos de eficiencia energética, acompañados por dos bloques de caché L3 de 16 MB. Esta aproximación permite distribuir diferentes tipos de cargas mientras NVIDIA busca optimizar tanto la potencia disponible como el consumo energético.
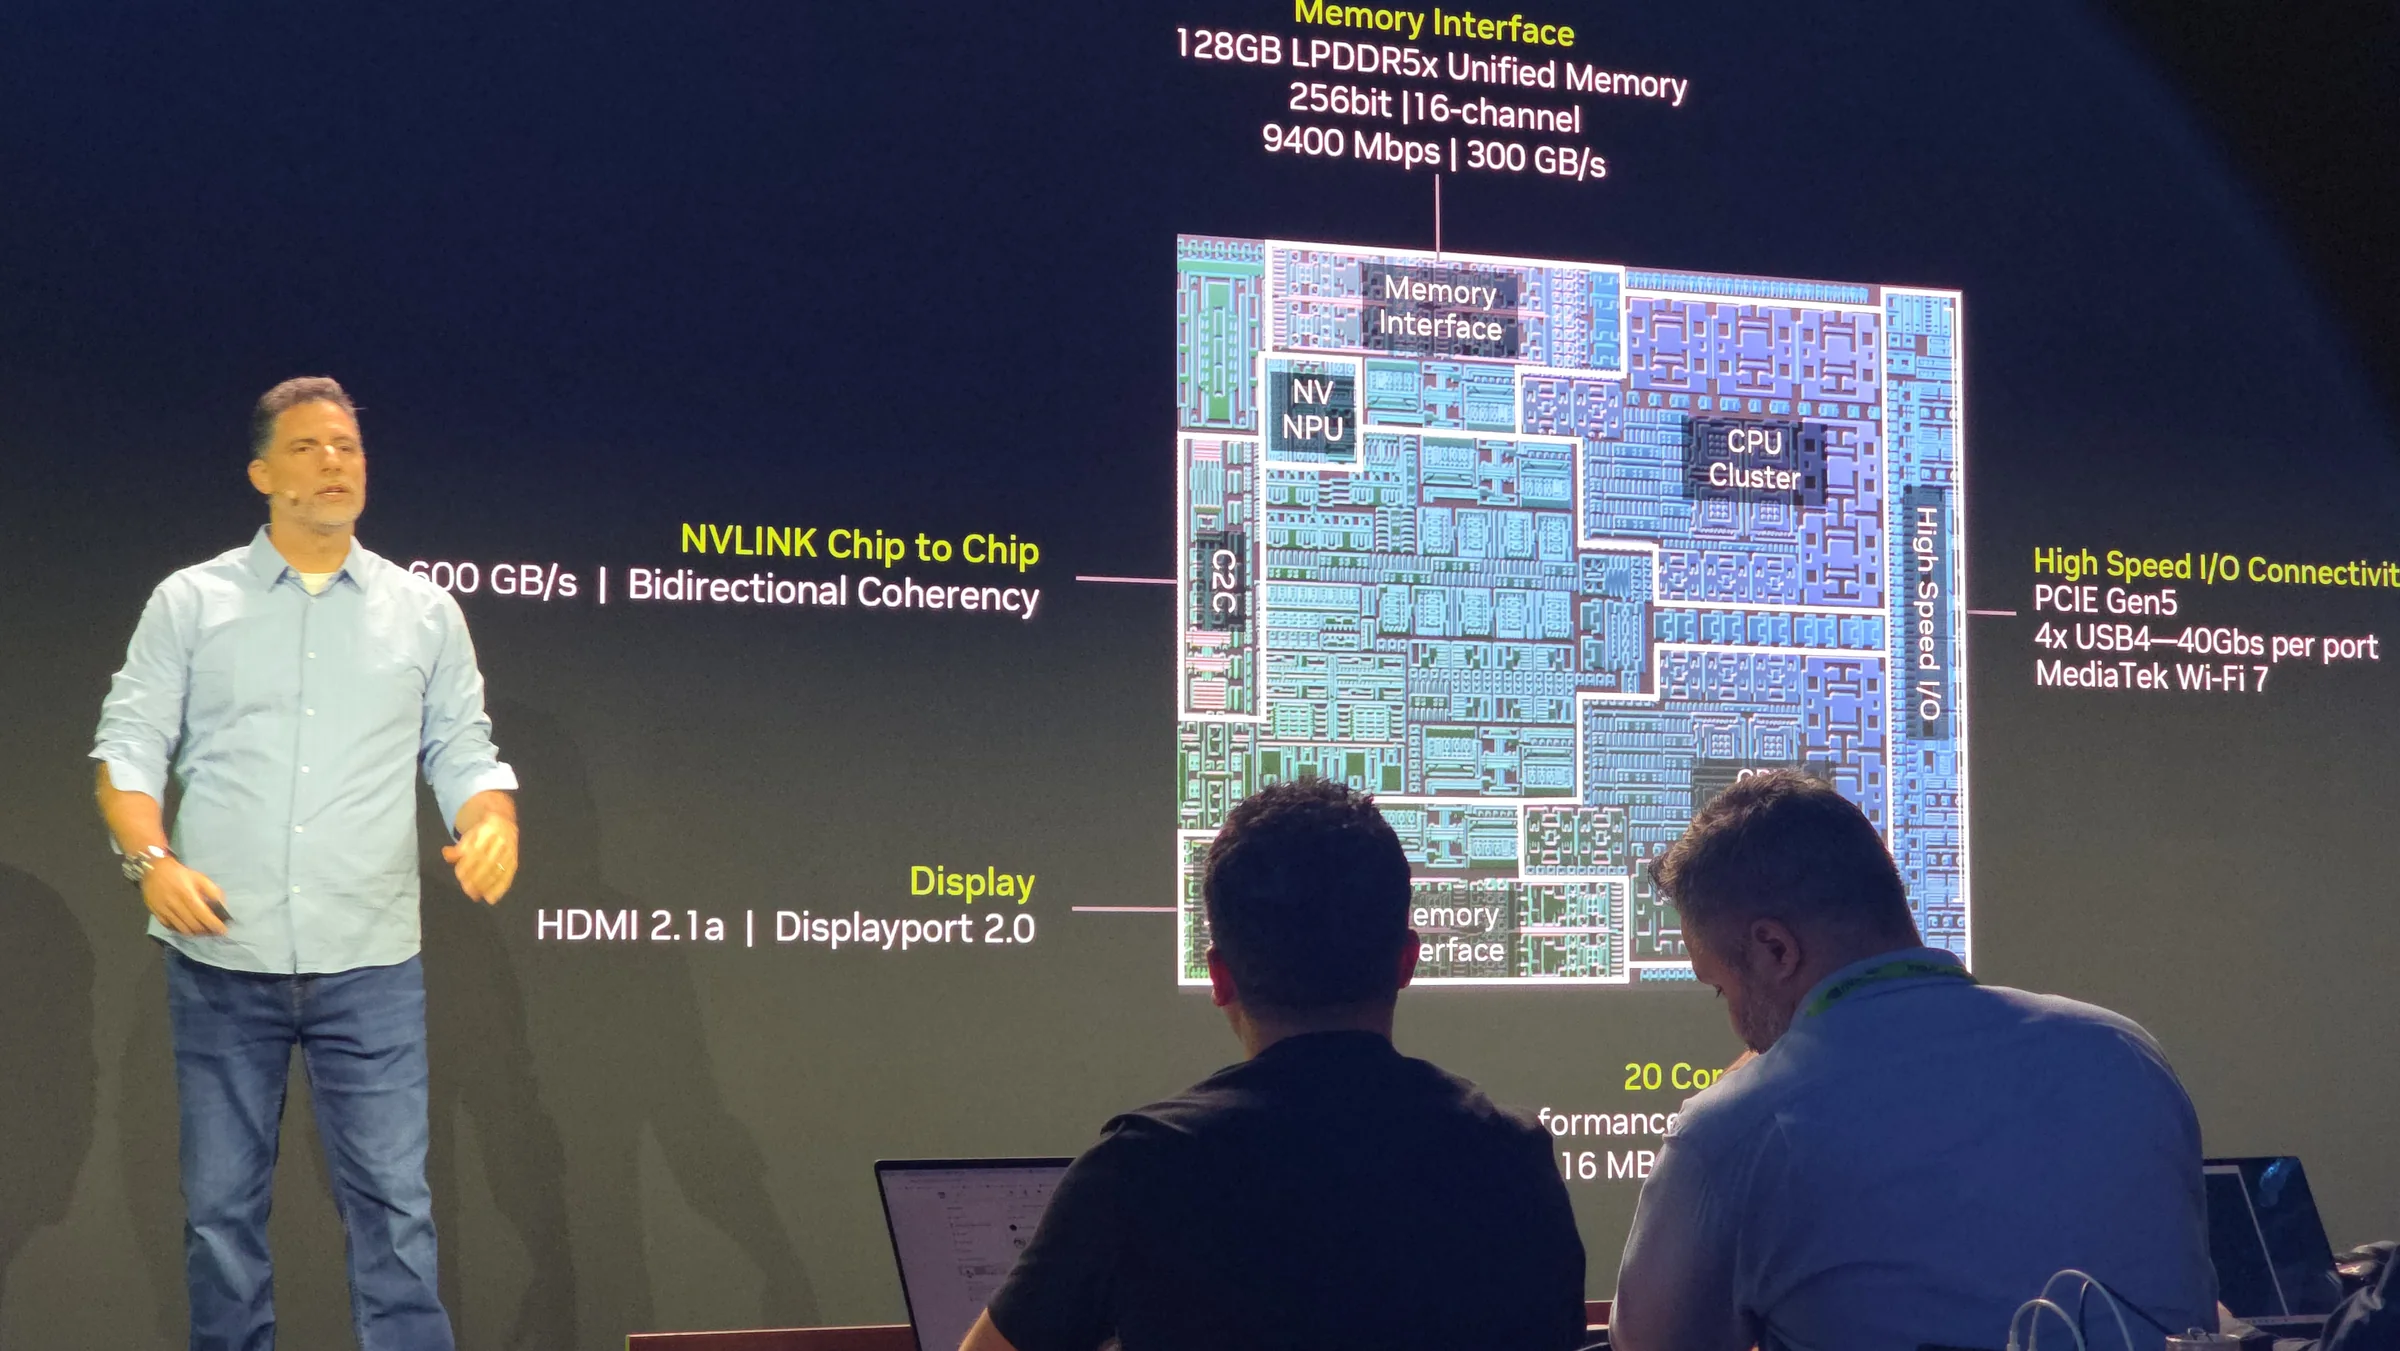
Una característica fundamental del diseño es NVLink-C2C dado que se requiere de una interconexión rapida y eficiente. Según la información presentada, esta interconexión alcanza hasta 600 GB/s y permite que CPU y GPU mantengan coherencia de caché (esto es uno de los puntos mas importantes de esta arquitectura). En términos prácticos, esto facilita trabajar con estructuras de datos compartidas sin recurrir constantemente a las transferencias tradicionales entre la memoria del sistema y una GPU independiente.
Aunque ¡OJO! conviene distinguir esta velocidad de interconexión del ancho de banda de la memoria principal. Son características diferentes y sus cifras no deben interpretarse como equivalentes.
Especificaciones técnicas de NVIDIA RTX Spark N1X
|
Característica |
NVIDIA RTX Spark N1X |
|---|---|
|
Arquitectura GPU |
NVIDIA Blackwell |
|
CUDA Cores |
5,120 / 6,144 |
|
Tensor Cores |
Quinta generación |
|
RT Cores |
Cuarta generación |
|
Arquitectura CPU |
NVIDIA Grace ARM |
|
Núcleos CPU (laptops) |
18 / 20 |
|
Memoria |
LPDDR5X unificada |
|
Capacidades de memoria |
24, 32, 48, 64 y 128 GB |
|
Interfaz de memoria |
256 bits |
|
Velocidad de memoria |
Hasta 9,400 MT/s |
|
Ancho de banda de memoria |
Aproximadamente 300 GB/s |
|
Interconexión CPU-GPU |
NVLink-C2C |
|
Ancho de banda NVLink-C2C |
Hasta 600 GB/s, según NVIDIA |
|
Rendimiento de IA anunciado |
Hasta 1 PFLOP en NVFP4 |
|
Sistema operativo |
Windows 11 |
|
Disponibilidad de laptops |
16 de octubre de 2026 |
|
Precio inicial anunciado |
2,599.99 USD |
Nota: Especificaciones y cifras anunciadas por NVIDIA, sujetas a variaciones según la configuración y el fabricante. Los resultados de rendimiento no representan pruebas independientes de DrogaDigital.
Hasta 128 GB de memoria unificada: el argumento más importante de RTX Spark
Una de las diferencias fundamentales entre RTX Spark y una PC convencional con tarjeta gráfica dedicada está en la organización de su memoria, que como ya he mencionado antes, es mas parecida a una consola de videojuegos o un telefono movil gracias a la memoria unificada, pero un un sistema tradicional, el CPU utiliza memoria RAM mientras la GPU dedicada dispone de su propia VRAM. Cuando una aplicación necesita procesar datos en ambos dispositivos, frecuentemente resulta necesario transferir información de un espacio de memoria al otro, con implicaciones para la latencia, el consumo energético y la administración de recursos, en contraste RTX Spark utiliza memoria LPDDR5X unificada, compartida entre CPU y GPU. Dependiendo de la configuración, los fabricantes pueden ofrecer equipos con capacidades desde 24 GB hasta 128 GB, para NVIDIA, esto representa una ventaja particularmente importante en inteligencia artificial, donde el tamaño de los modelos suele estar limitado por la memoria disponible para almacenar sus parámetros, cachés y otros datos necesarios durante la inferencia.
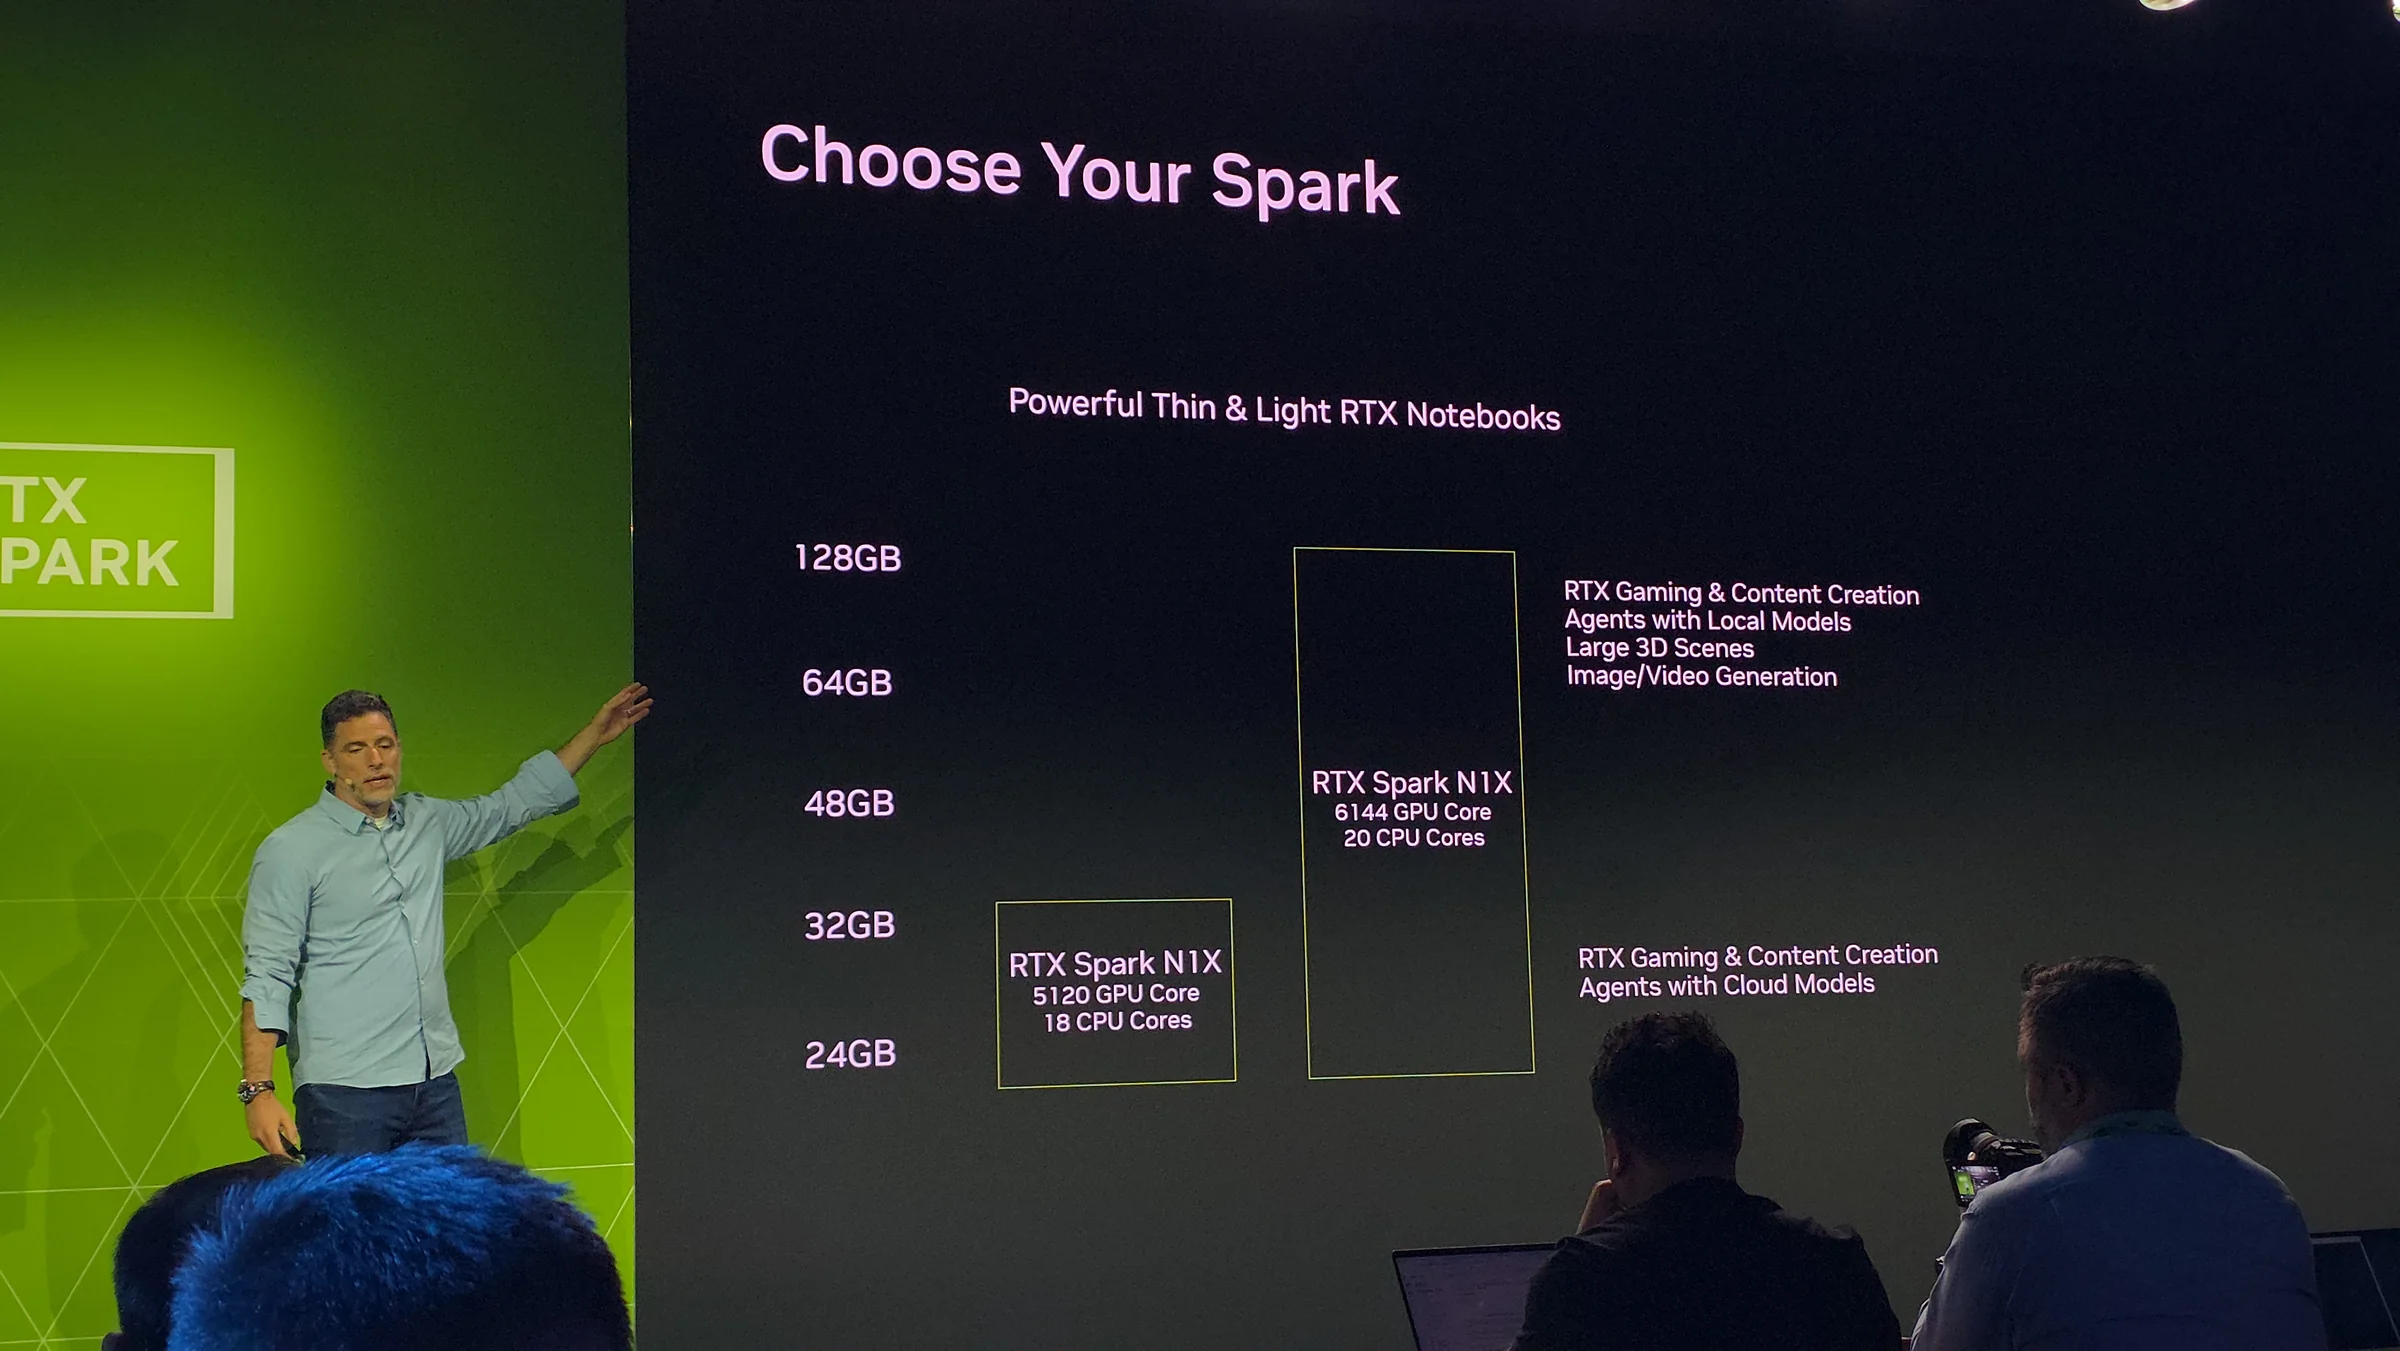
Una limitante "artificial" en una GPU de consumo es la falta de memoria suficiente, con 16 GB de VRAM, dicha tarjeta puede ofrecer un rendimiento computacional considerable, pero tendrá dificultades para mantener en memoria modelos cuyo tamaño supere esa capacidad. Una plataforma con 64 o 128 GB de memoria unificada puede ejecutar cargas mucho más grandes sin depender de las mismas estrategias de descarga de datos hacia la memoria del sistema por las que tiene que pasar la GPU de nuestro ejemplo, pero s'i que hay que aclarar que las RTX Spark NO TIENEN el equivalente a 128 GB de VRAM GDDR7.
La memoria LPDDR5X presenta características diferentes, particularmente en ancho de banda. NVIDIA describió una interfaz de 256 bits con velocidades de hasta 9,400 MT/s y un ancho de banda aproximado de 300 GB/s, una tarjeta gráfica dedicada de alto rendimiento puede superar ampliamente esa cifra utilizando GDDR7, mientras que las aceleradoras profesionales con HBM operan en otra categoría de ancho de banda. Por eso, una mayor capacidad de memoria no implica automáticamente más rendimiento, pero si garantiza acceso a modelos mas grandes, y aunque se trabaje relativamente mas lento, se puede.
El beneficio de RTX Spark es notorio cuando la capacidad disponible permite ejecutar una carga que no cabría completamente en una GPU convencional. En esos escenarios, mantener los datos en memoria compartida puede resultar más útil que disponer de una GPU considerablemente más rápida, pero limitada por su VRAM.
NVIDIA quiere que los agentes de inteligencia artificial funcionen dentro de nuestras computadoras
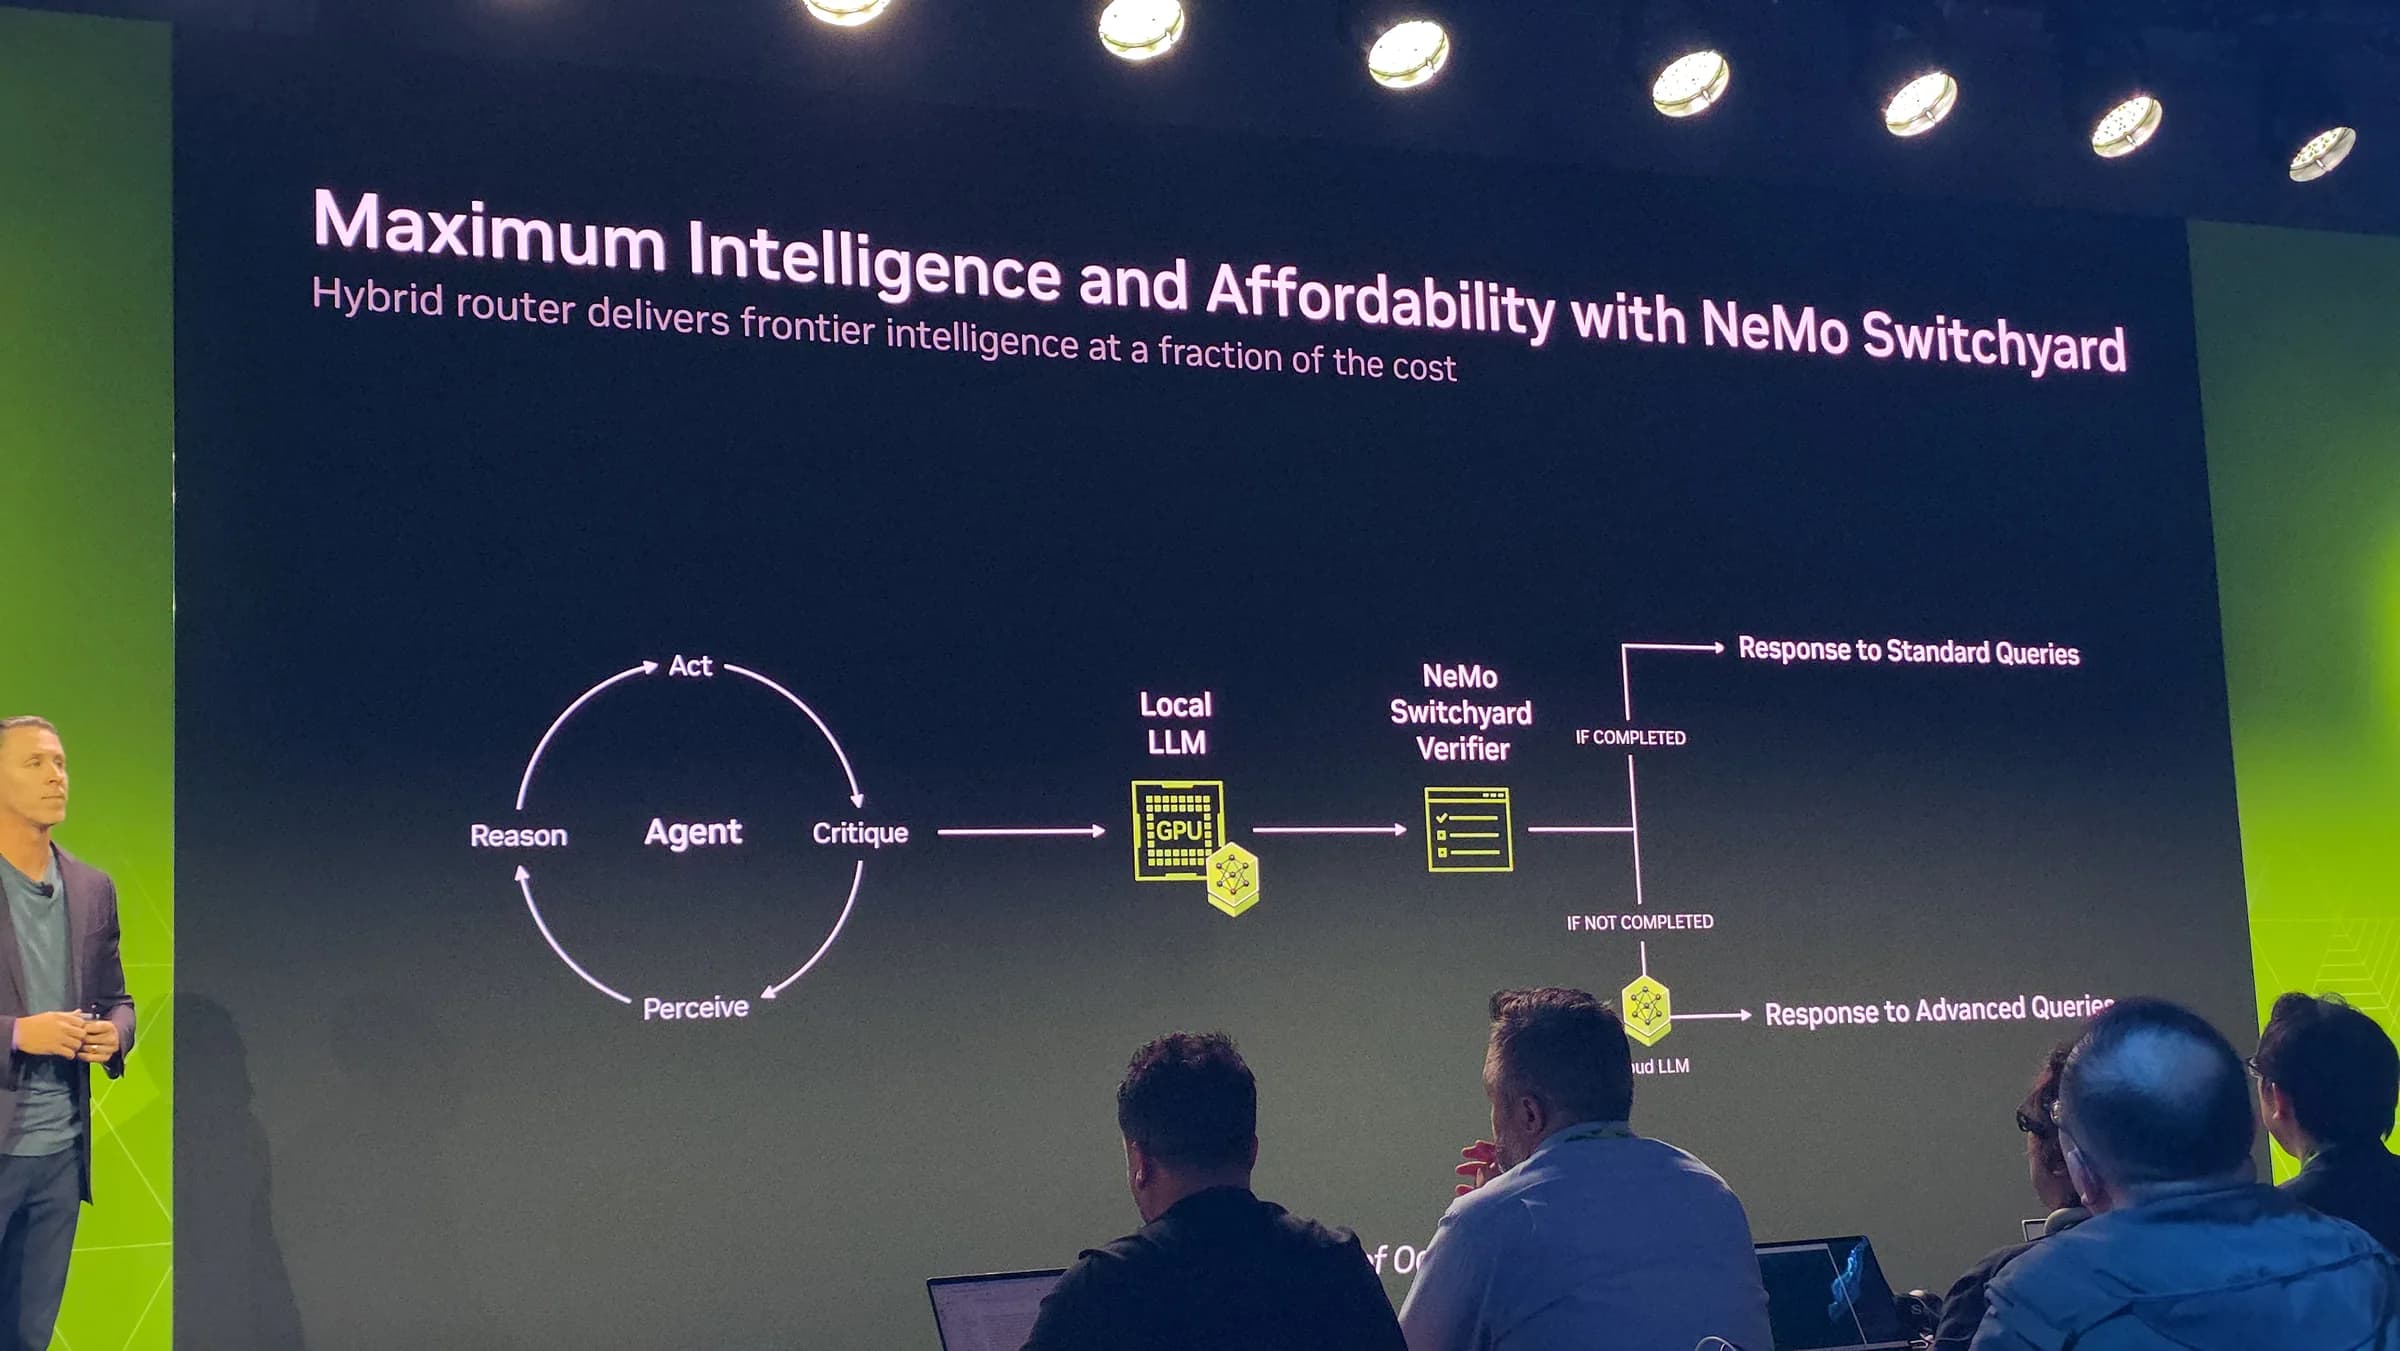
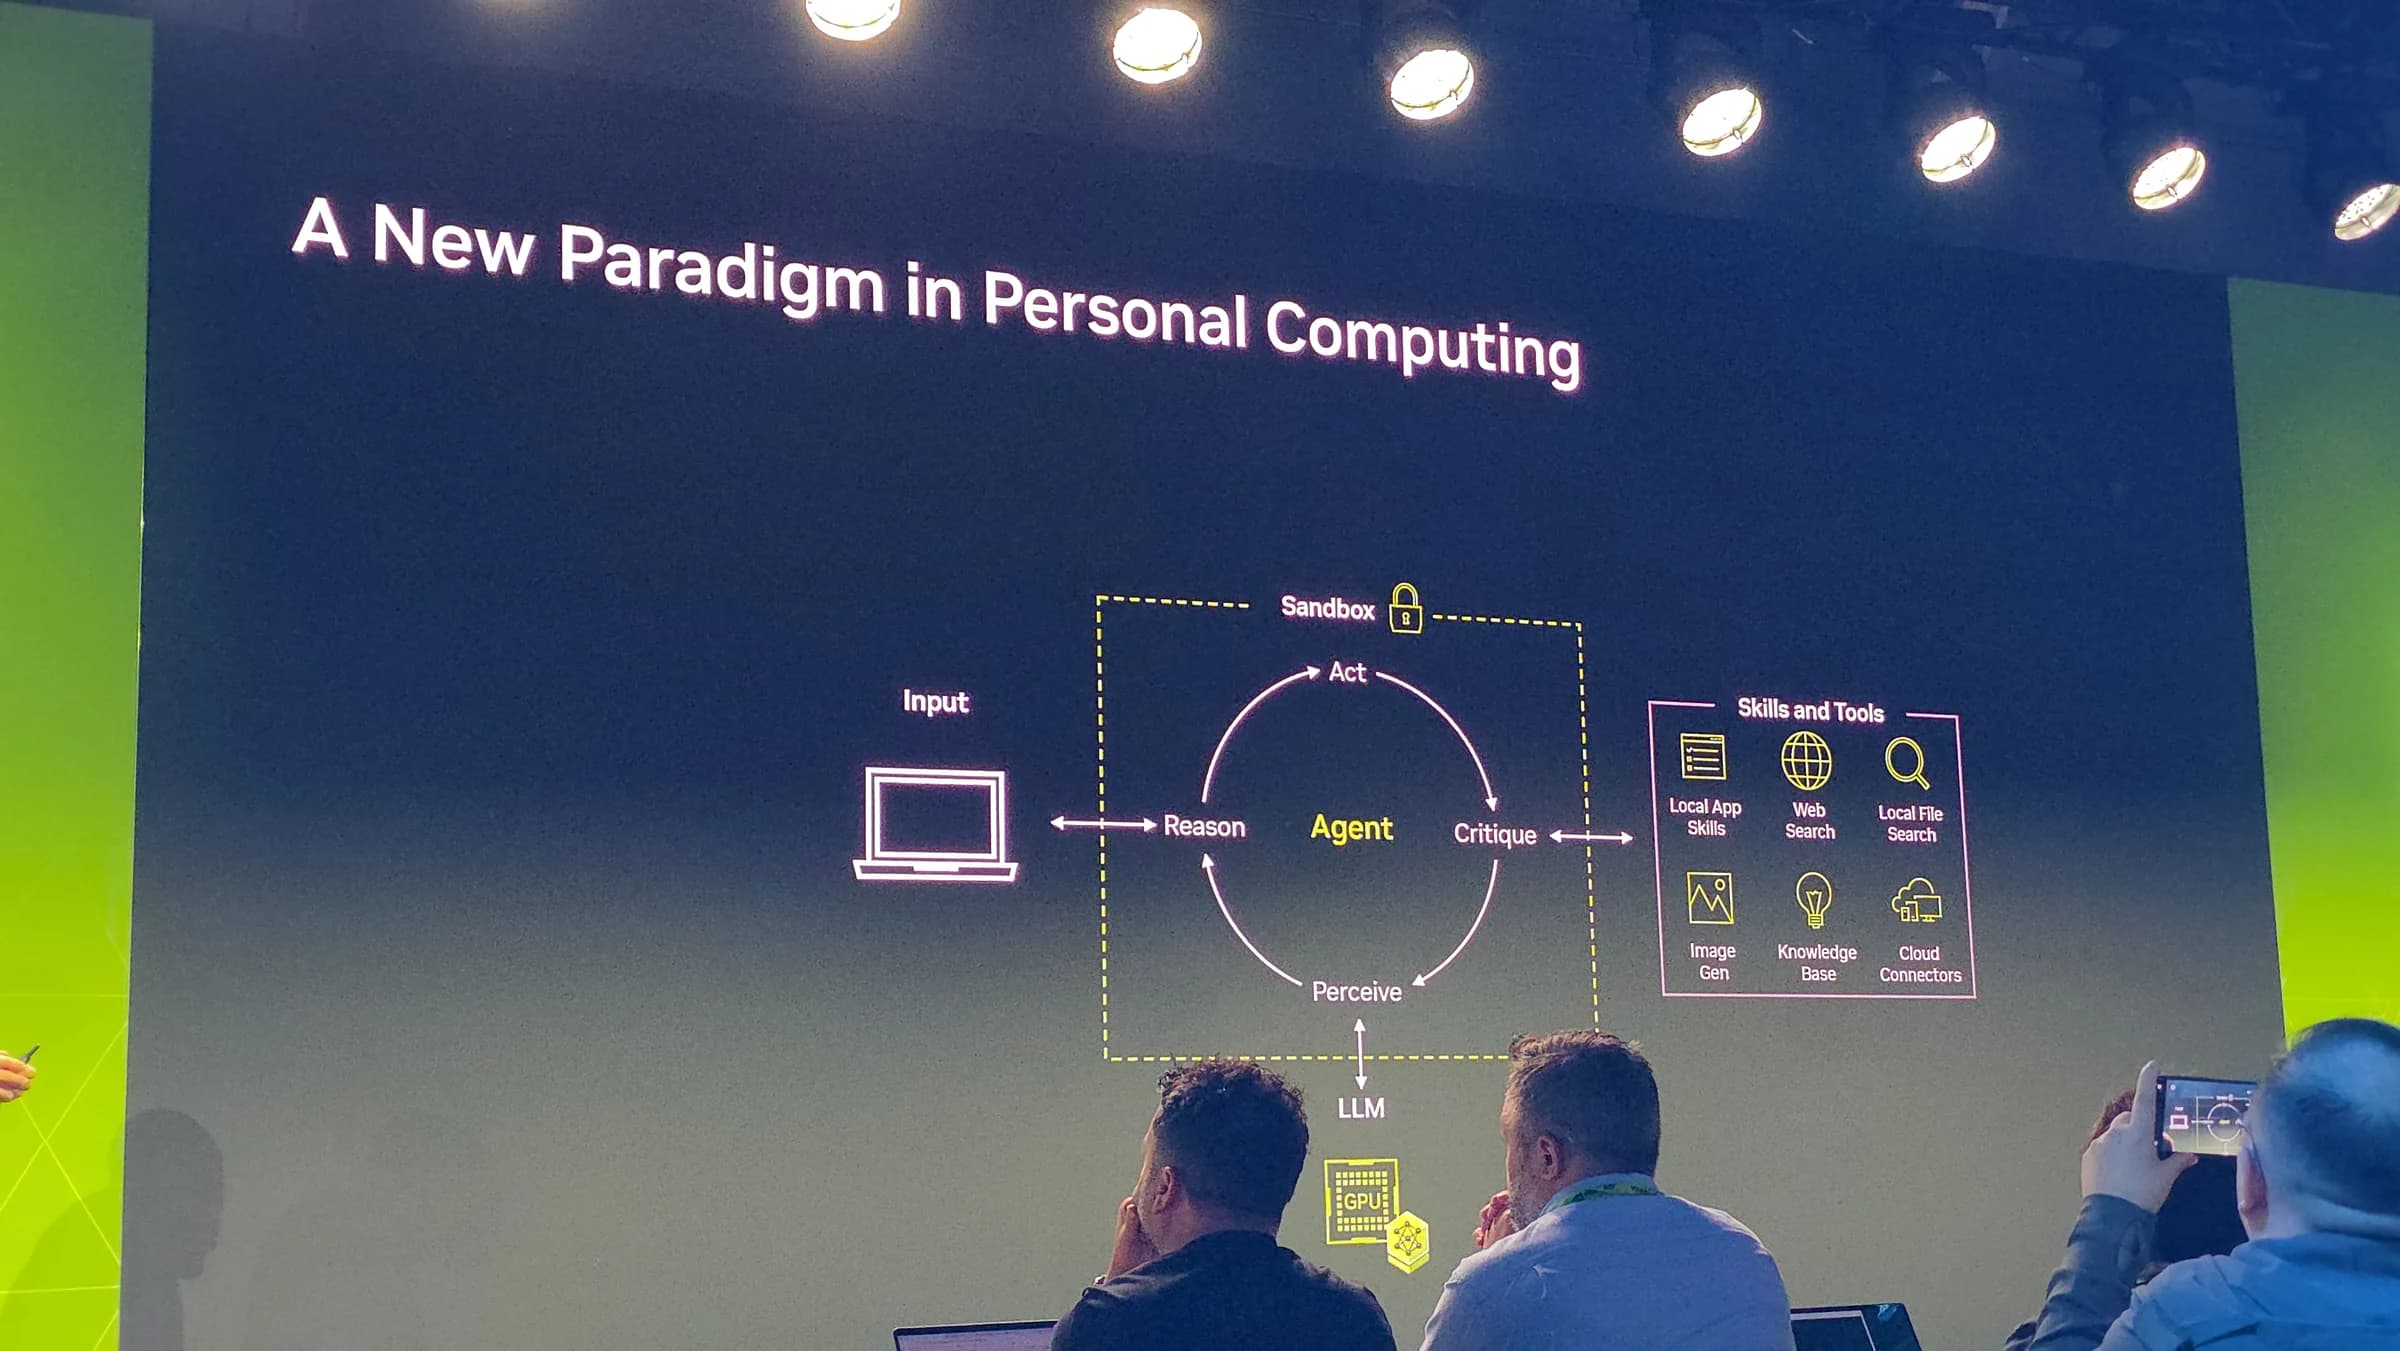
Como ya es costumbre, la inteligencia artificial local fue uno de los temas centrales de la presentación, y como contexto veamos las 1,600 millones de descargas de modelos de IA locales durante 2026, una cifra que, según sus estimaciones, representa un crecimiento de cinco veces respecto al año anterior, este crecimiento se considera que está relacionado con una tendencia hacia sistemas capaces de ejecutar modelos de lenguaje, analizar información, generar contenido y realizar tareas automatizadas sin enviar continuamente todos los datos a servidores externos. NVIDIA sostiene que los modelos abiertos y las herramientas para ejecutarlos están avanzando rápidamente, tanto en sus capacidades como en la eficiencia con la que utilizan los recursos disponibles.
RTX Spark busca aprovechar esta evolución mediante la combinación de una GPU Blackwell, grandes cantidades de memoria y soporte para operaciones de baja precisión como NVFP4. NVIDIA atribuye a sus configuraciones superiores hasta 1 PFLOP de rendimiento de IA bajo condiciones específicas. Es una cifra importante, aunque no debe compararse directamente con rendimiento FP16, FP32 o benchmarks de inferencia sin considerar precisión, sparsity y metodología. Un valor teórico de operaciones tampoco determina por sí solo la cantidad de tokens por segundo que puede generar un modelo de lenguaje.
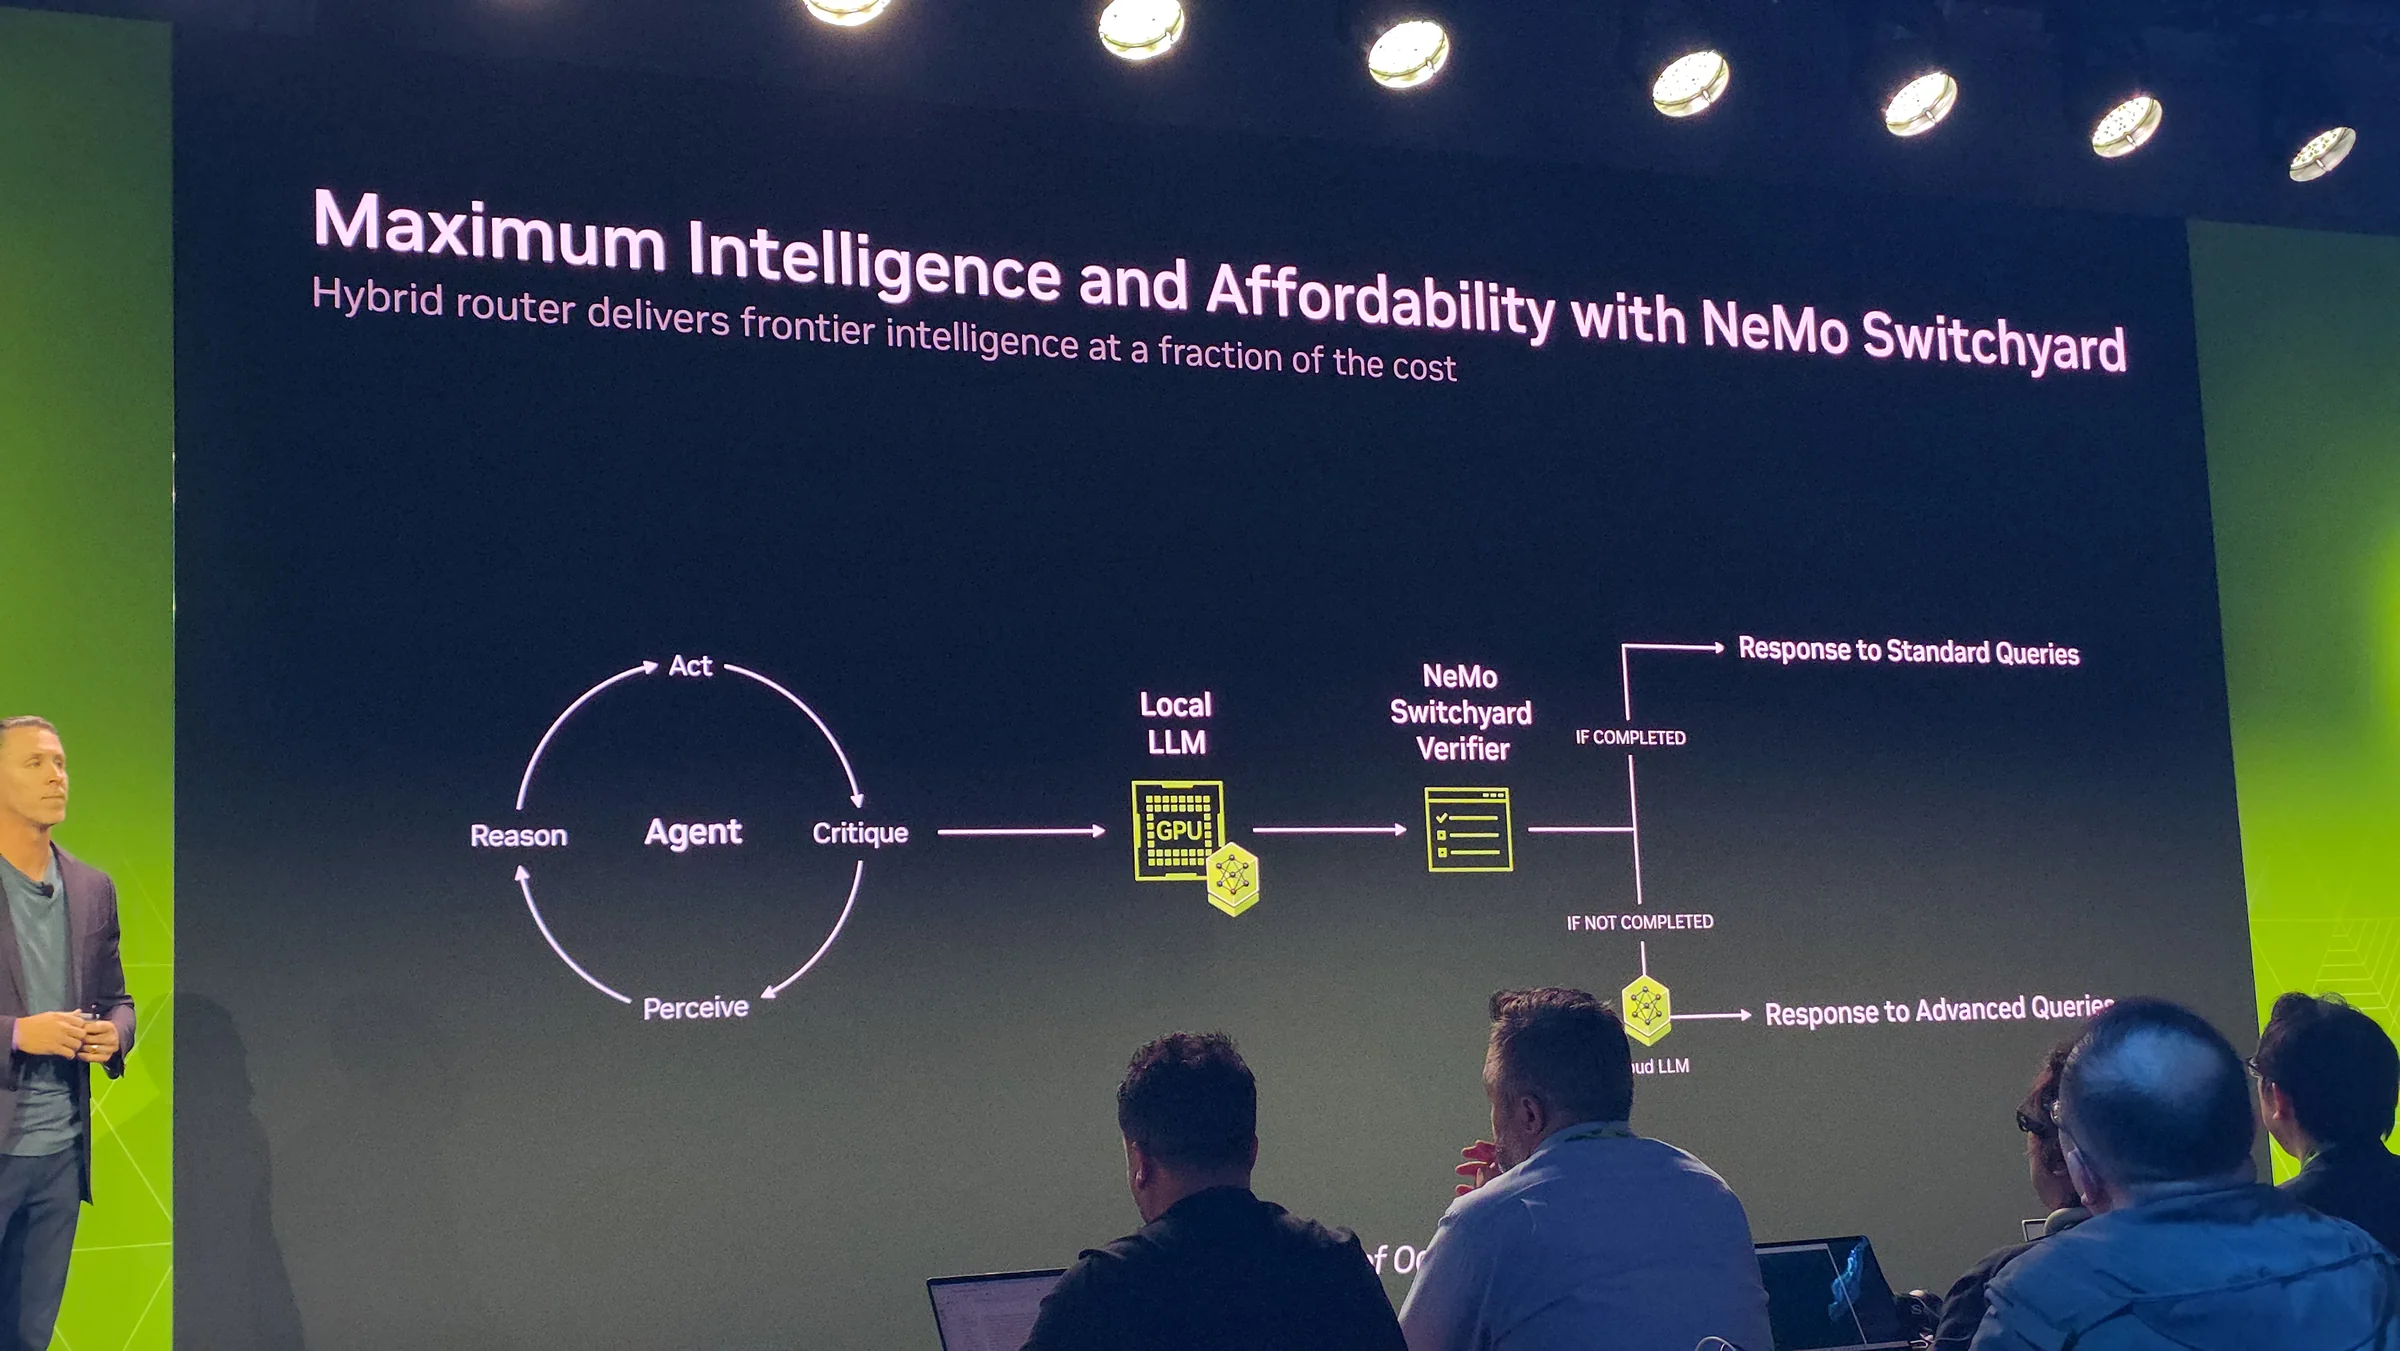
NVIDIA también afirmó que determinadas configuraciones de RTX Spark podrán ejecutar modelos para agentes con aproximadamente 125,000 millones de parámetros. La viabilidad práctica dependerá de factores como la cuantización, la longitud del contexto, la memoria utilizada por el sistema operativo y los recursos adicionales que requiera cada aplicación.
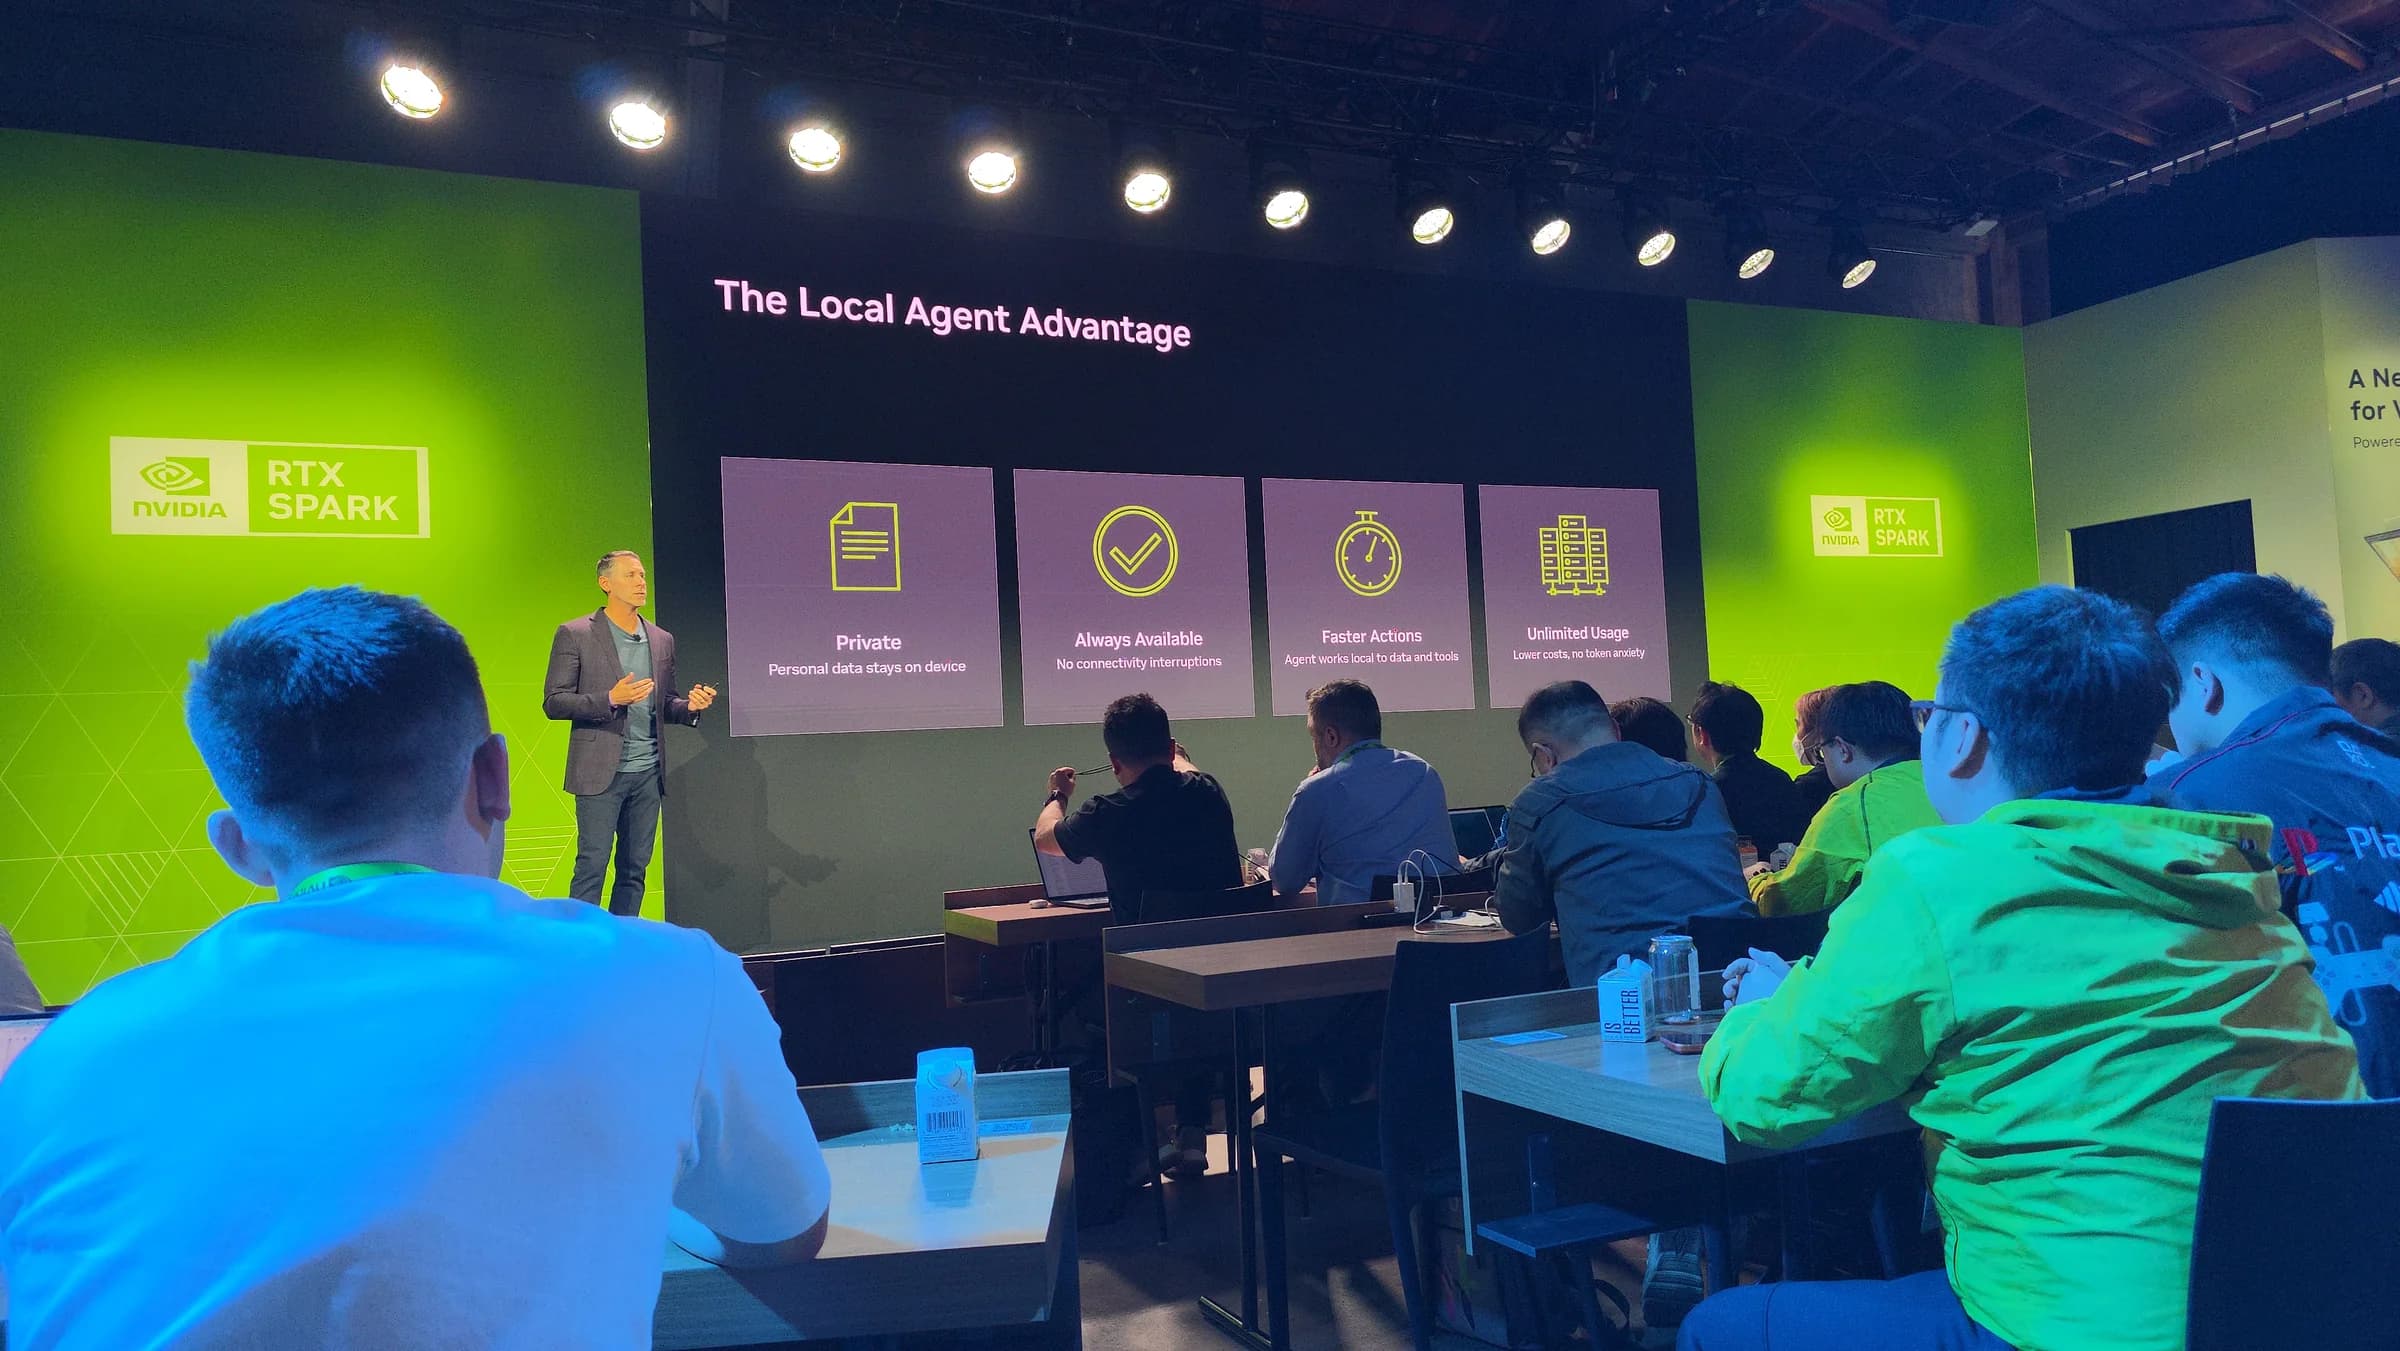
Para un desarrollador, tener suficiente memoria para mantener modelos grandes dentro del propio equipo puede traer posibilidades interesantes a la mesa. Entre ellas se encuentran asistentes que procesan documentos privados, sistemas de automatización, aplicaciones de generación de contenido y agentes capaces de interactuar con herramientas locales y también existe una ventaja potencial en términos de privacidad y control de datos. Ejecutar un modelo localmente puede reducir la necesidad de transferir información hacia servicios externos, aunque esto no garantiza automáticamente que una aplicación sea segura. El comportamiento del software, los permisos del sistema y las conexiones que realice cada agente siguen siendo factores fundamentales.
RTX Spark también quiere conquistar el gaming: DLSS 5, juegos competitivos, personajes con IA y RTX Remix
Uy, ahora si llegamos a una parte sensible para varios potenciales clientes, NVIDIA quiere que tambien se considere esta plataforma como un "powerhouse" en GAMING, y mientras que el GPU Blackwell incorpora tecnologías RTX como ray tracing, DLSS y Reflex, además de soporte para DLSS 5 y funciones de renderizado neuronal, el CPU al ser ARM puede traer problemas de compatibilidad, pero no nos adelantemos, las tecnologías RTX de Spark significan que la plataforma contará con capacidades gráficas asociadas al ecosistema GeForce, aunque su rendimiento dependerá de los límites energéticos y térmicos establecidos por cada fabricante, como ocurre siempre con las laptops.
Durante la presentación NVIDIA explicó que RTX Spark se apoya en tres elementos: el hardware Blackwell con núcleos RT y Tensores, el conjunto de controladores y tecnologías RTX desarrollado durante años para GeForce, y su colaboración directa con estudios de videojuegos. Este último punto adquiere especial importancia porque, al utilizar procesadores ARM en lugar de x86-64, la plataforma necesita resolver desafíos de compatibilidad que van más allá de ofrecer suficiente rendimiento gráfico, tambien se mostraron escenarios de gaming a 1440p y más de 100 FPS en determinados títulos. Sin embargo, estas cifras no deben interpretarse como una garantía de rendimiento general. La configuración gráfica, el juego utilizado, las técnicas de reconstrucción y generación de cuadros, así como el consumo energético, pueden modificar considerablemente el resultado.
También existe otra consideración importante: Windows sobre ARM, que es mi principal queja de este producto, a diferencia de los procesadores x86-64 utilizados tradicionalmente por Intel y AMD, el N1X emplea una arquitectura de instrucciones ARM. Esto significa que la compatibilidad con determinadas aplicaciones y videojuegos depende de que existan versiones nativas, o bien de mecanismos de emulación y soporte de controladores y aunque Microsoft ha trabajado en ampliar la compatibilidad de Windows con esta arquitectura, disponer de una GPU Blackwell no elimina las posibles limitaciones del software. Algunas aplicaciones profesionales, herramientas especializadas y sistemas de protección utilizados por videojuegos pueden requerir validaciones adicionales o tener que ser escritas desde cero solo para que funcionen.
En creación de contenido, NVIDIA destacó capacidades de procesamiento de video 4:2:2, renderizado 3D y aceleración para generar imágenes y secuencias de video mediante inteligencia artificial. La compañía también mostró ejemplos de generación de video 4K a 60 FPS en tiempos reducidos, aunque estos resultados necesitan analizarse considerando el modelo utilizado, la duración del contenido y las condiciones de ejecución.
Cientos de videojuegos desde el lanzamiento y una apuesta por los esports
NVIDIA aseguró que RTX Spark tendrá soporte para cientos de videojuegos desde su lanzamiento, incluyendo títulos recientes como Gears of War: E-Day, AION 2, Control Resonant, Animo y NBA 2K27, además de World of Warcraft: Forever, tal como apareció identificado durante la presentación, la compañía destacó que esta compatibilidad inicial es resultado de su colaboración con desarrolladores, Microsoft y proveedores de tecnologías relacionadas con videojuegos. Sin embargo, una de las dificultades más importantes para Windows sobre ARM se encuentra en los sistemas antitrampas, que frecuentemente requieren integración de bajo nivel con el sistema operativo.
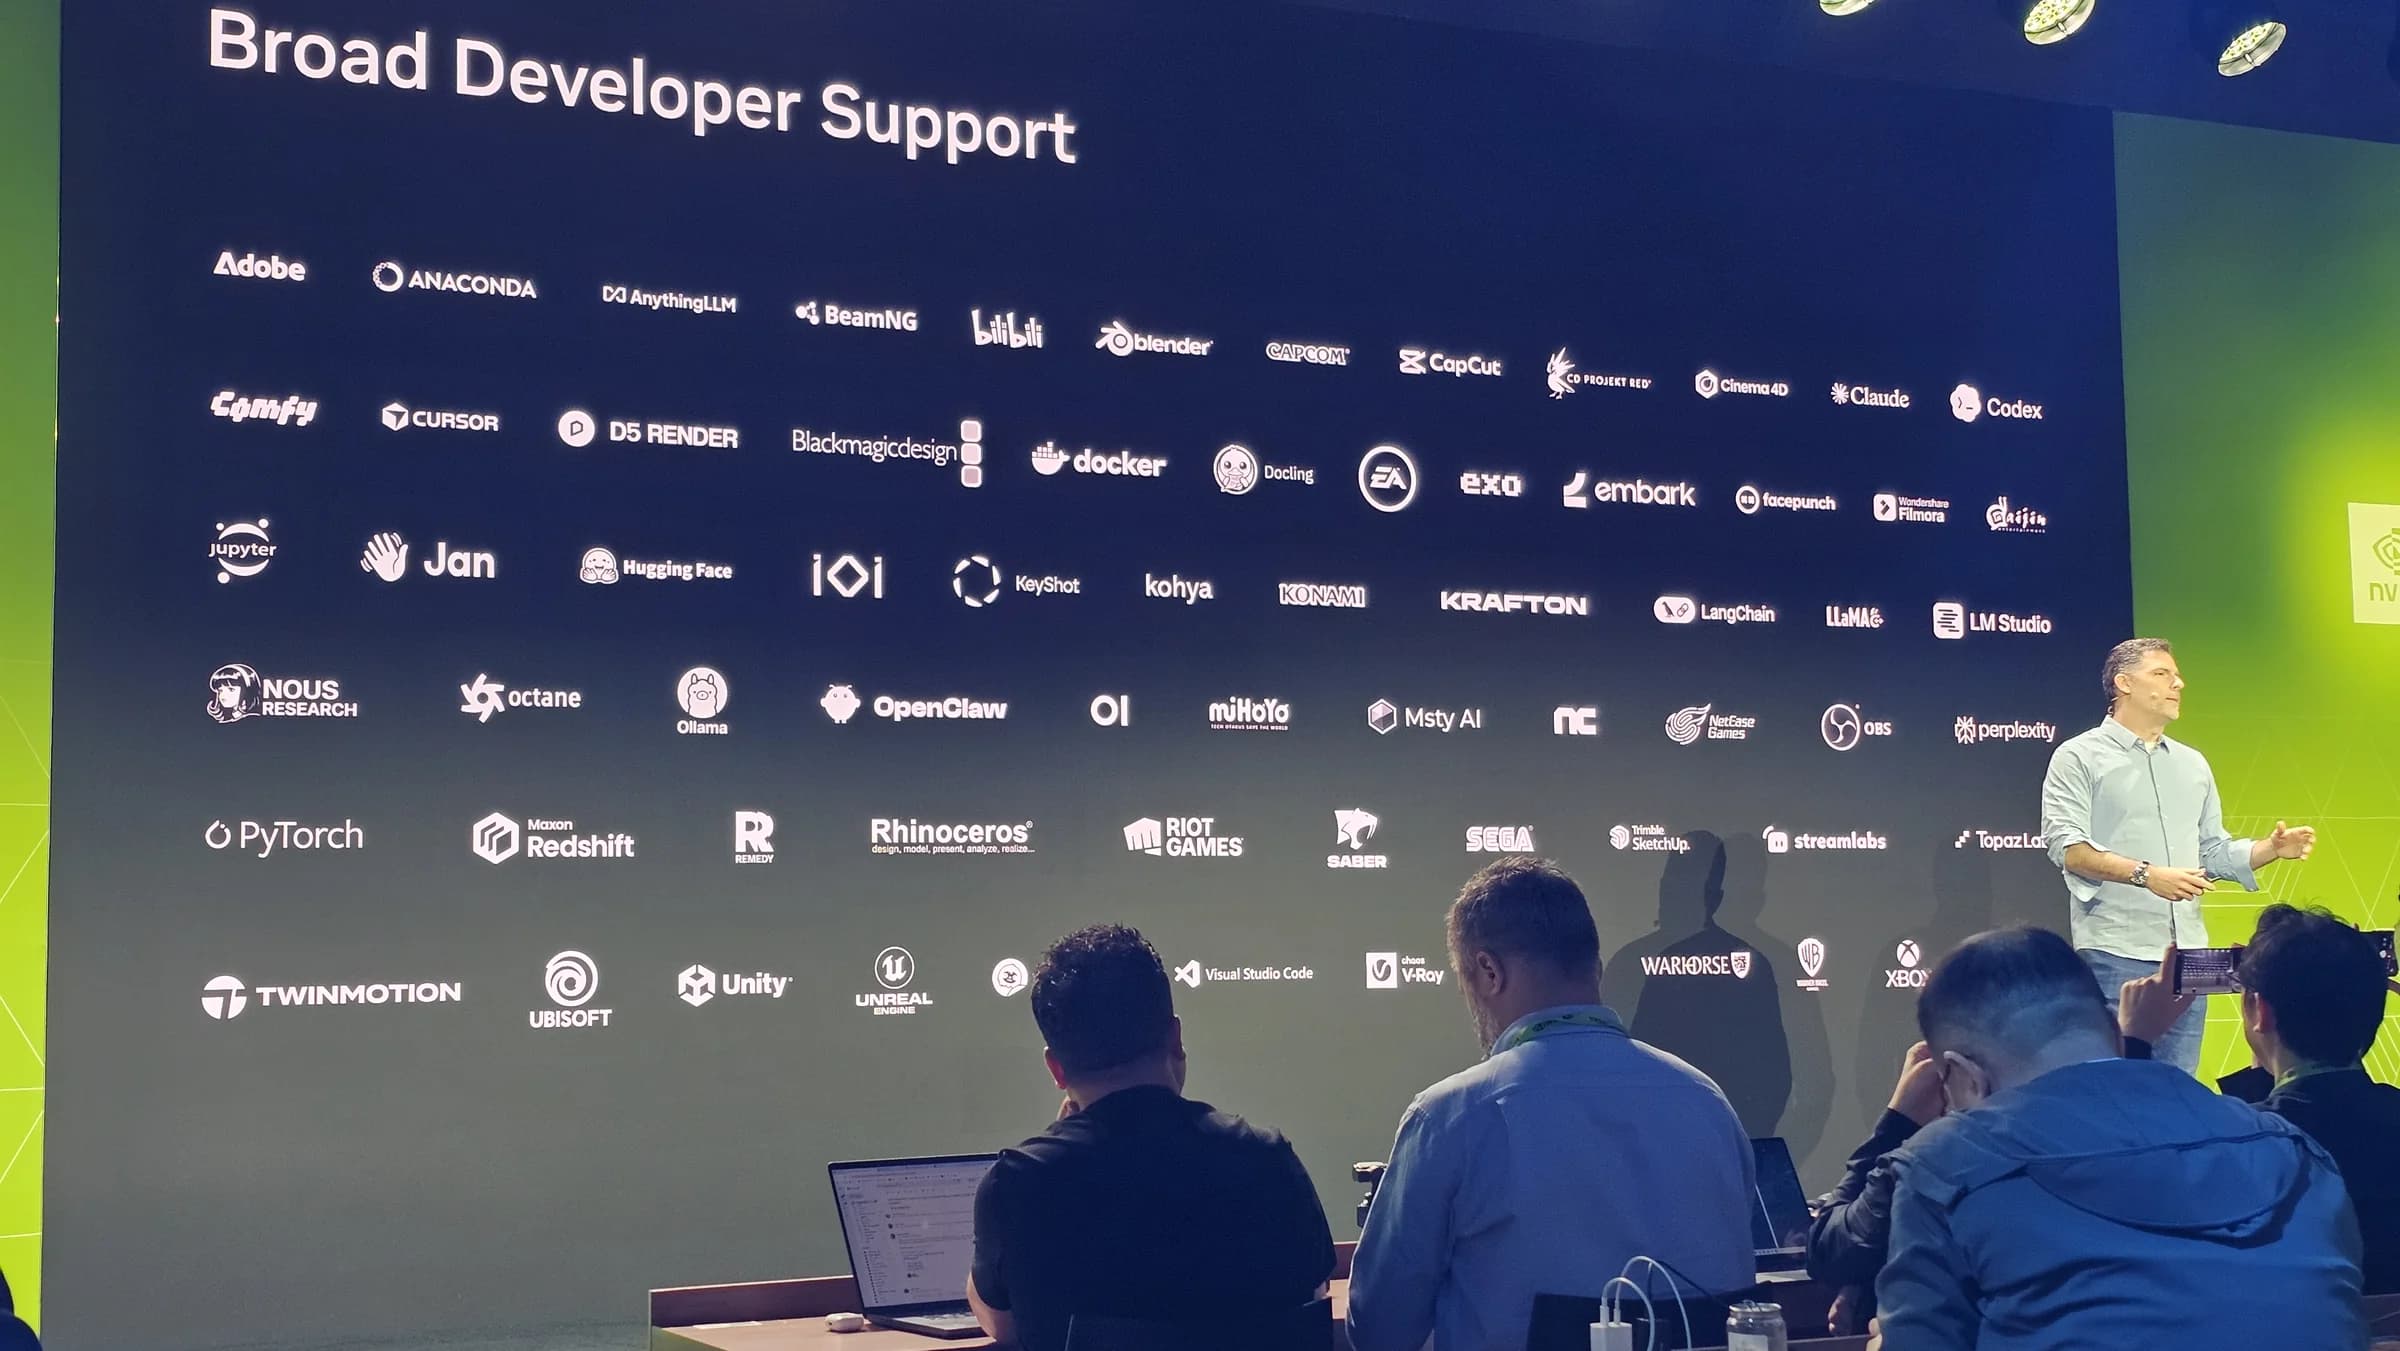
También se anunciaron colaboraciones con Krafton para PUBG: Battlegrounds, Electronic Arts para su sistema EA Javelin Anticheat, Activision para Call of Duty y Riot Games para League of Legends y Valorant. Estas iniciativas buscan ampliar la disponibilidad de juegos competitivos en RTX Spark, donde la compatibilidad con los mecanismos de seguridad puede resultar tan importante como el rendimiento de CPU o GPU.
En contexto, NVIDIA intenta aprovechar su experiencia con GeForce para reducir una de las barreras históricas de Windows sobre ARM. Sin embargo, el soporte anunciado no es automáticamente compatibilidad universal con todos los videojuegos, versiones y sistemas anticheat existentes.
DLSS 5 continúa evolucionando y recibe mejoras de rendimiento
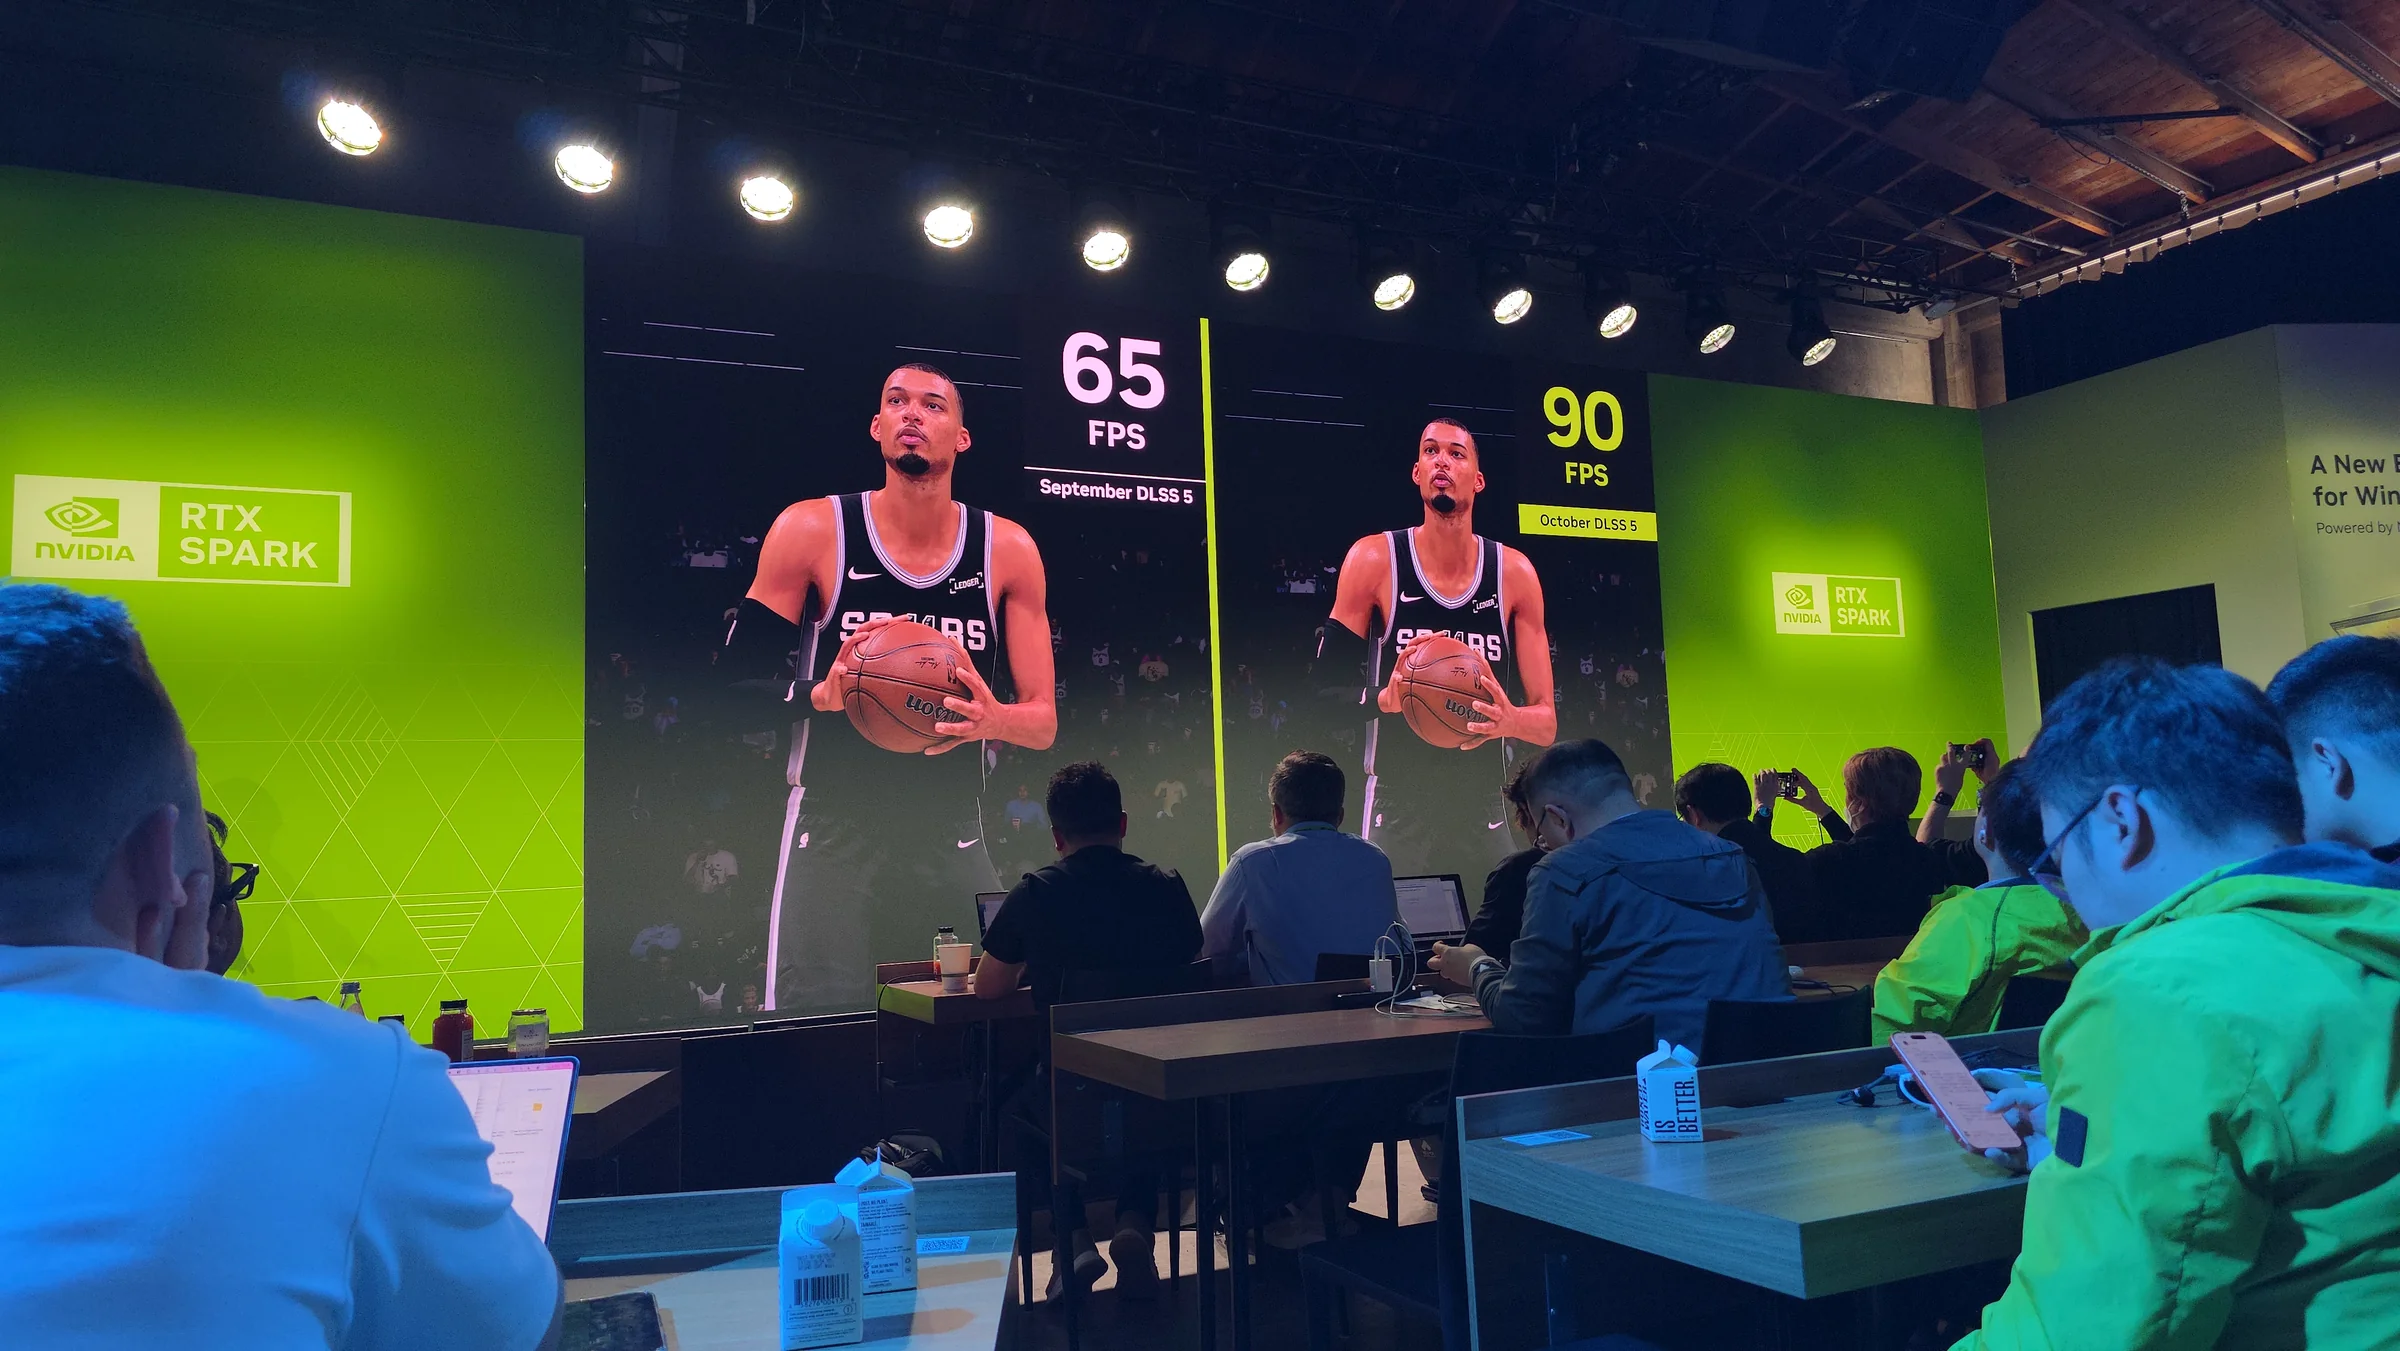
Hablemos ahora de las actualizaciones de NVIDIA DLSS 5, una tecnología de renderizado neuronal que utiliza modelos de inteligencia artificial para mejorar características visuales como iluminación, materiales y sombras, aprovechando información tridimensional de la escena, durante 2026 se han realizado diversas actualizaciones incluyendo mejoras en Super Resolution mediante modelos Transformer de segunda generación, multi frame gen de hasta 6X y una segunda generación de Ray Reconstruction.
Para octubre, tambien se anunció una actualización del modelo de DLSS 5 que, según sus propias mediciones, duplica la velocidad de procesamiento frente a la versión presentada en septiembre y estará disponible para RTX Spark y tarjetas GeForce RTX 50 compatibles, entre las primeras implementaciones se encuentra NBA 2K27, cuyo contenido de la temporada 2 recibirá la actualización el 16 de octubre y permitirán mejorar aproximadamente 30% el rendimiento del juego en RTX Spark bajo las condiciones de su demostración, manteniendo una experiencia de juego a 1440p.
Otra novedad es un modo Performance para Frame Generation que busca reducir los recursos necesarios para generar cuadros adicionales. En lugar de utilizar uno de los modelos secundarios de inteligencia artificial, la nueva implementación recurre a un algoritmo más ligero para calcular información de movimiento en elementos especialmente complejos, como interfaces y detalles de tamaño reducido, con esta actualización se puede mejorar hasta 30% el rendimiento de Frame Generation, dependiendo del multiplicador utilizado, aunque introduce pequeños artefactos en calidad visual. La función llegará como beta a NVIDIA App a partir del 13 de octubre, con soporte anunciado para RTX Spark y las familias GeForce RTX 40 y RTX 50.
Las demostraciones también incluyeron mejoras visuales en Hogwarts Legacy, cuyo soporte para DLSS 5 está previsto para el 5 de noviembre, y Where Winds Meet, que recibirá compatibilidad hacia finales de noviembre. En ambos casos, NVIDIA destacó el uso de renderizado neuronal para mejorar la apariencia de materiales, superficies e iluminación, además de controles para ajustar la intensidad de los efectos y preservar la dirección artística de cada juego.
Nemotron 3.5 Bolt E4B: personajes que utilizan inteligencia artificial para interactuar con el jugador
Nemotron 3.5 Bolt E4B es un modelo de lenguaje pequeño desarrollado para impulsar personajes controlados por inteligencia artificial mediante NVIDIA ACE. Su objetivo es permitir que los NPC puedan interpretar instrucciones, mantener conversaciones y tomar decisiones considerando el contexto del juego, sin depender exclusivamente de árboles de diálogo predefinidos, este modelo ofrece una precisión 1.5 veces mayor en determinadas tareas de agentes conversacionales frente a la generación anterior. También incorpora modos configurables de conversación y razonamiento para que los desarrolladores ajusten el equilibrio entre calidad de respuesta y velocidad de ejecución.
Durante la presentación se mostraron ejemplos de aplicaciones anteriores de NVIDIA ACE, incluyendo asistentes para jugadores de PUBG y personajes inteligentes en Animo. También se explicó un flujo de procesamiento que combina reconocimiento de voz, interpretación mediante Nemotron y generación de respuestas o acciones dentro del juego, con apoyo de tecnologías de síntesis de voz como Qwen TTS.
Nemotron 3.5 Bolt E4B tiene disponibilidad anunciada para el 23 de octubre. Para RTX Spark, esta clase de aplicaciones resulta especialmente interesante porque la memoria unificada permite mantener modelos de inteligencia artificial y recursos del videojuego dentro del mismo sistema, aunque su impacto sobre el rendimiento gráfico y la latencia tendrá que evaluarse en implementaciones reales.
RTX Spark también busca reemplazar algunas configuraciones con GPU dedicada
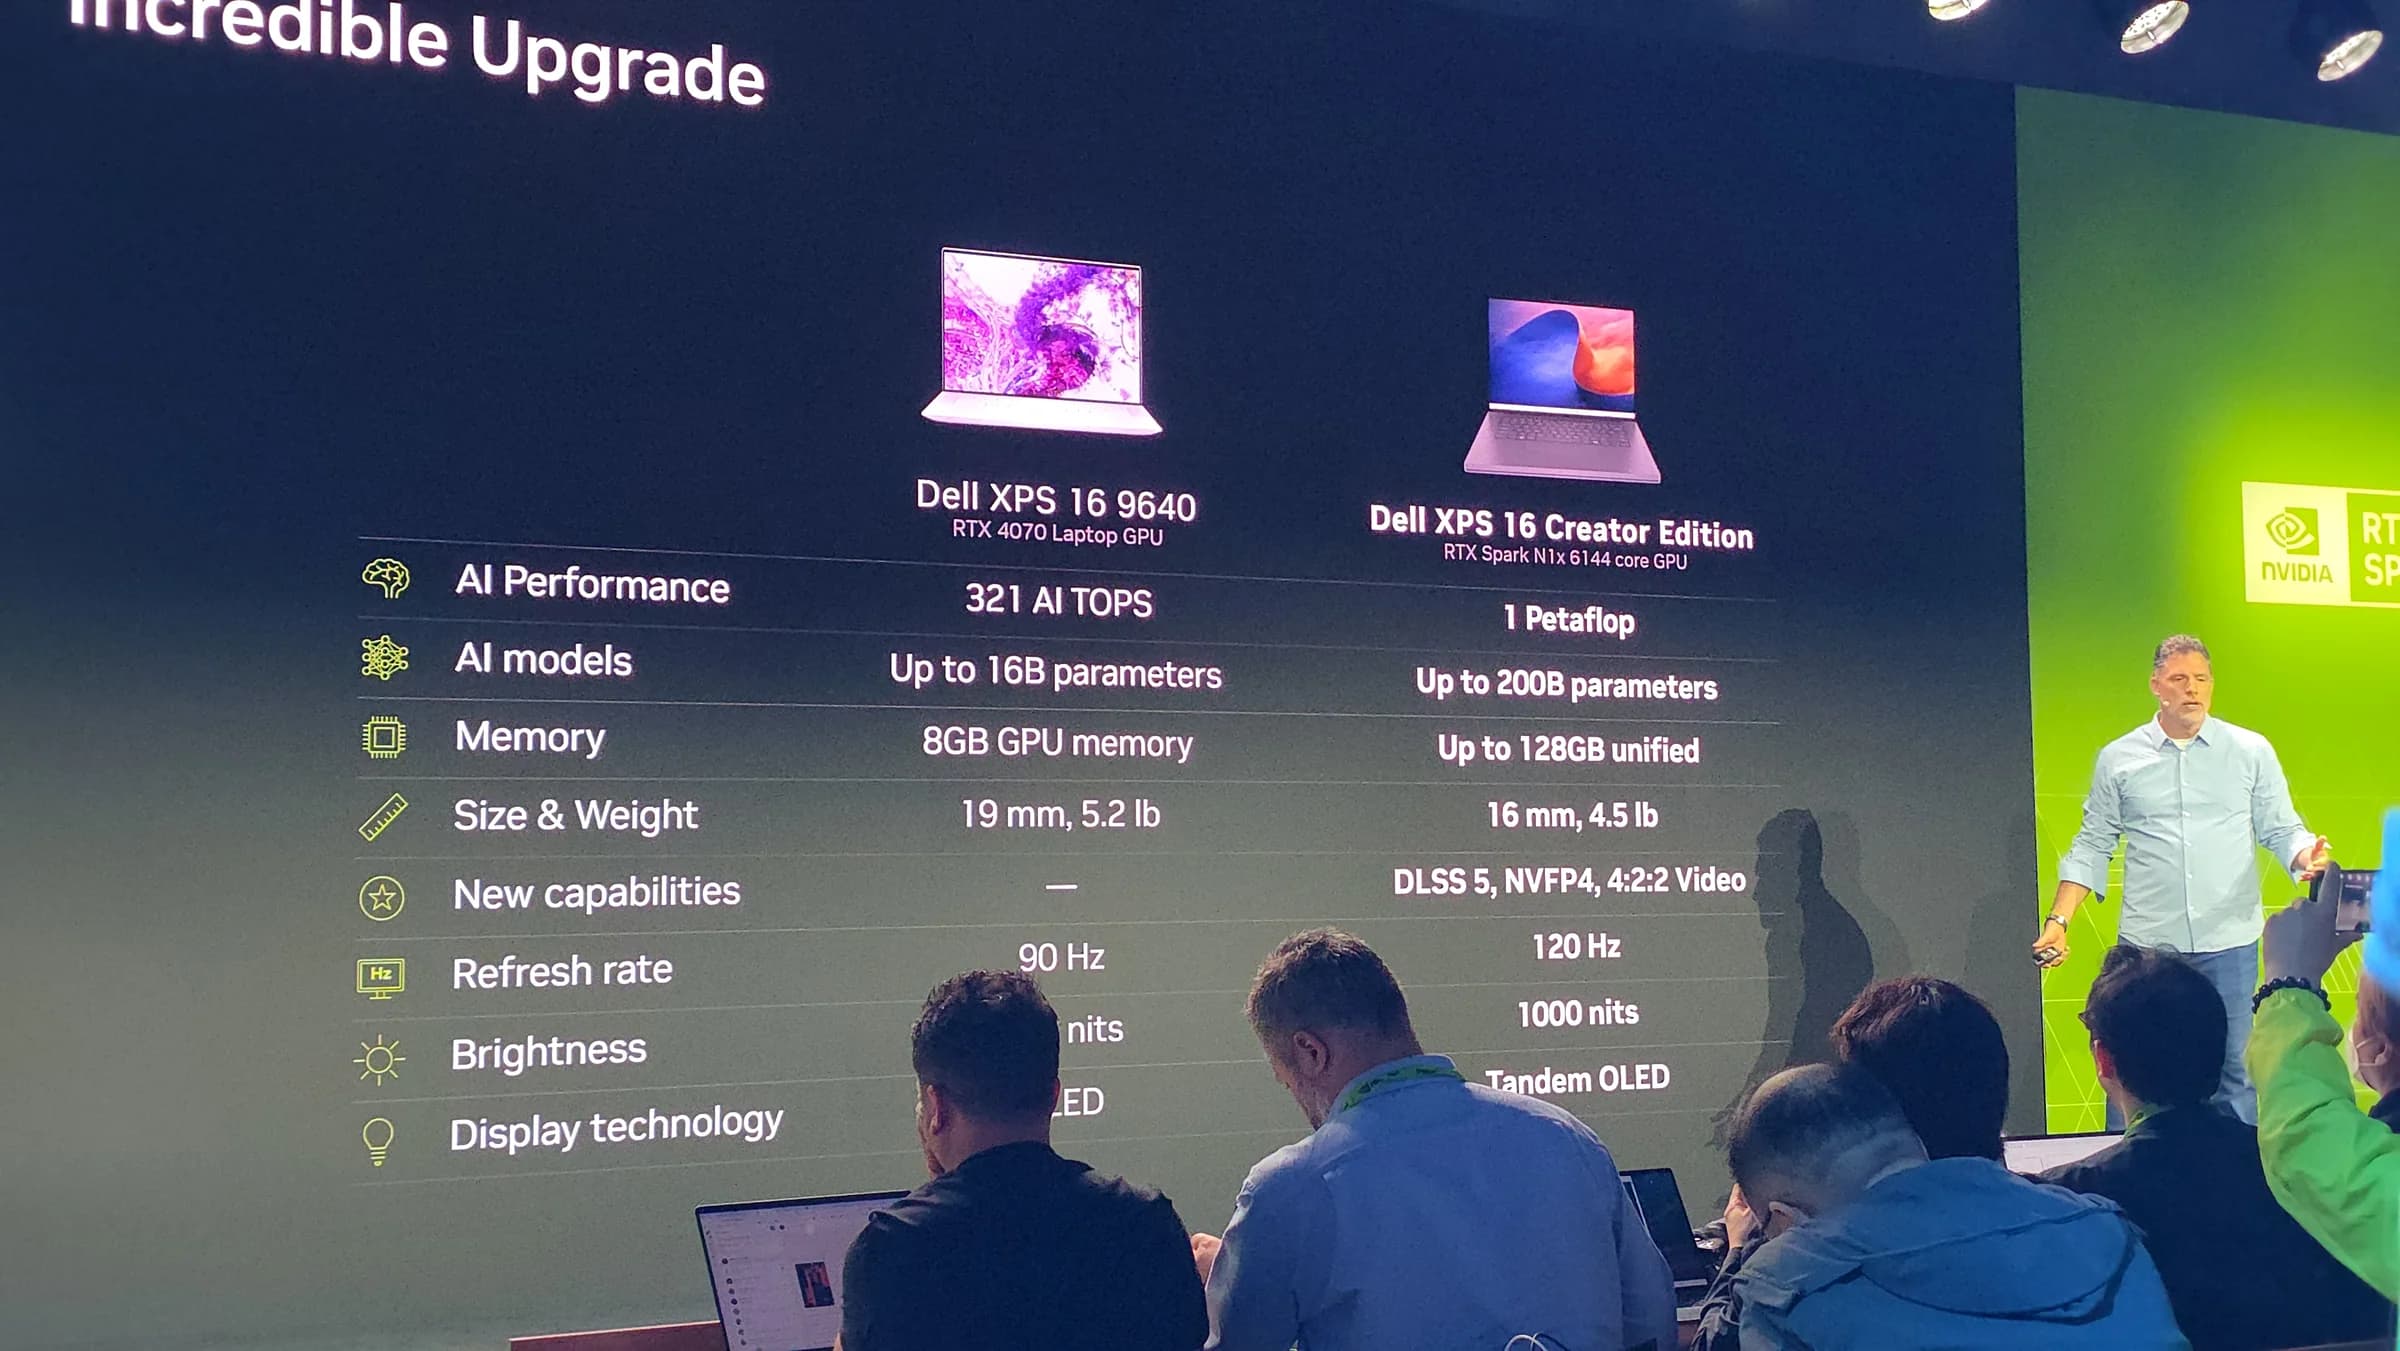
NVIDIA mostró una comparación entre un sistema RTX Spark y una laptop Dell de aproximadamente tres años de antigüedad equipada con una GeForce RTX 4070 Laptop GPU y según sus resultados, RTX Spark podía triplicar determinados indicadores de rendimiento computacional e inteligencia artificial, además de ejecutar modelos hasta 12 veces más grandes gracias a la capacidad de memoria disponible aqui es donde esta comparación permite entender el enfoque comercial, aunque es importante considerar que se utilizaron plataformas de distintas generaciones y configuraciones de memoria.
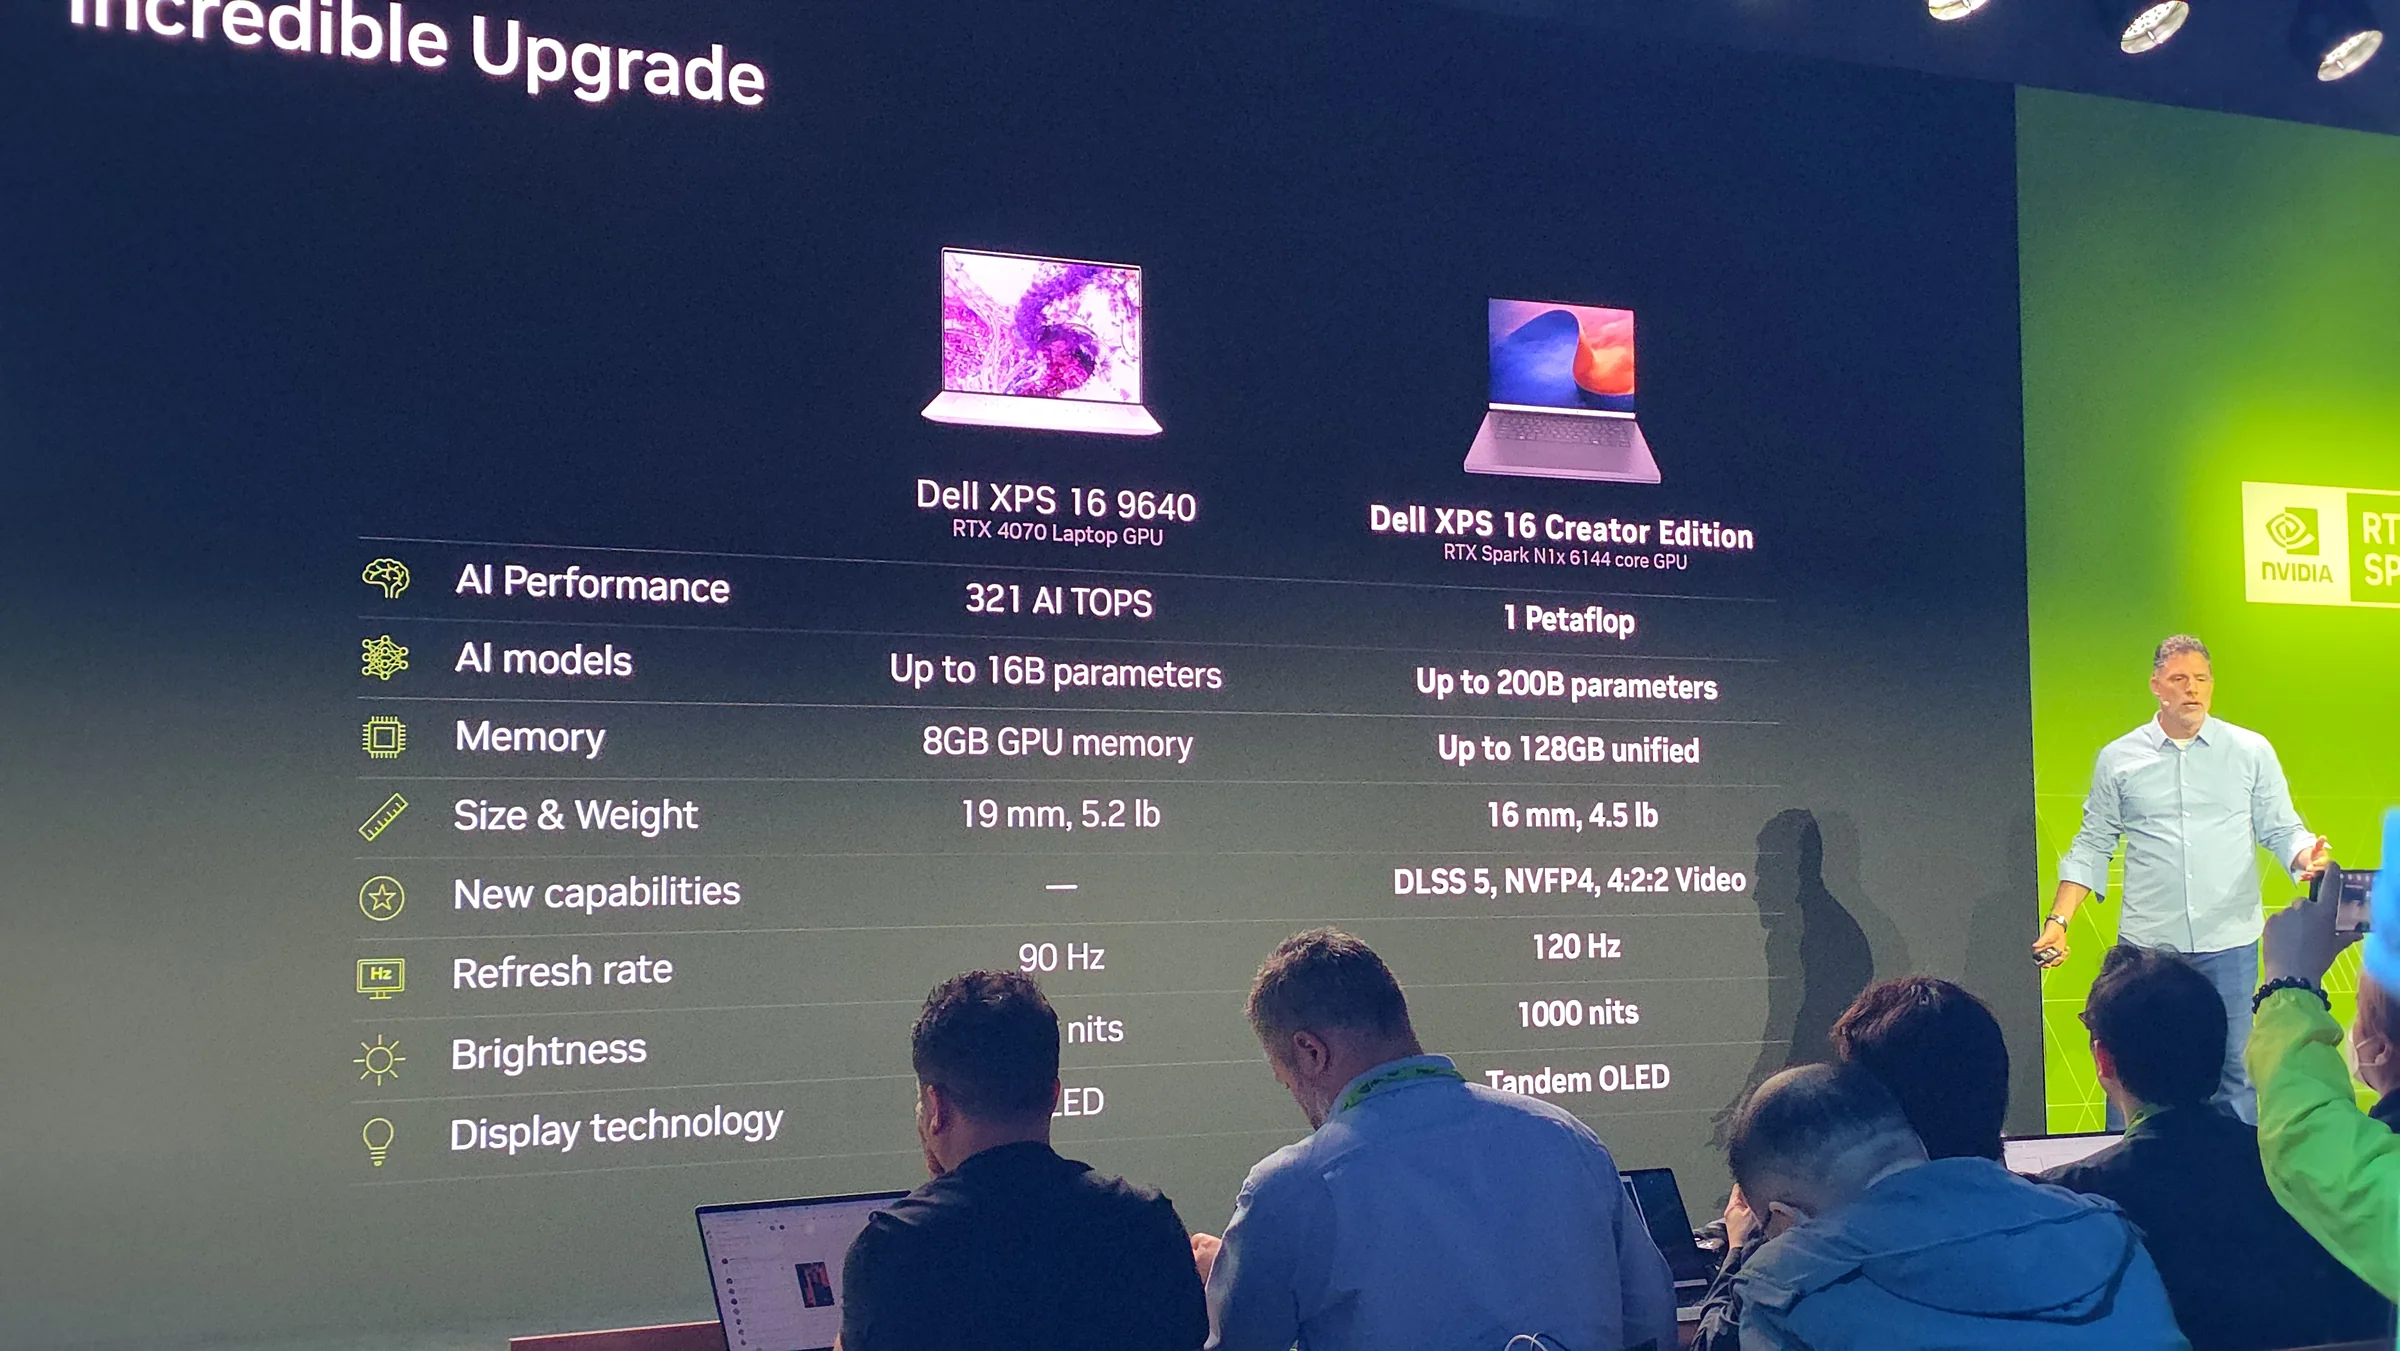
La posibilidad de ejecutar modelos más grandes no demuestra necesariamente una mejora proporcional en velocidad. Una plataforma puede admitir una red neuronal considerablemente mayor y, al mismo tiempo, procesar menos tokens por segundo que otra GPU al ejecutar un modelo pequeño, la elección dependerá del tipo de trabajo. Para videojuegos y aplicaciones que aprovechan grandes cantidades de ancho de banda gráfico, una GPU dedicada de alto rendimiento puede continuar ofreciendo ventajas importantes. Para desarrollo de IA y cargas limitadas principalmente por memoria, RTX Spark plantea una alternativa distinta.
Precios y primeras computadoras con RTX Spark
Las primeras laptops RTX Spark están programadas para comenzar a entregarse el 16 de octubre de 2026, con un precio de entrada de 2,599.99 dólares en Estados Unidos, entre los fabricantes que han anunciado equipos se encuentran Microsoft, ASUS, Dell, HP, Lenovo y MSI, con modelos dirigidos tanto a usuarios profesionales como a creadores de contenido y desarrolladores, esto incluye configuraciones considerablemente diferentes. Por ejemplo, Microsoft presenta su Surface Laptop Ultra con opciones de 18 y 20 núcleos CPU, GPU Blackwell de hasta 6,144 CUDA Cores y capacidades de memoria que llegan a 128 GB.
El precio de entrada corresponde a equipos con configuraciones más modestas, mientras que las variantes de memoria superior pueden alcanzar precios mucho mayores. En la tienda estadounidense de Microsoft, una Surface Laptop Ultra con 128 GB aparece anunciada por 5,899.99 dólares.
También vendrán computadoras de escritorio compactas para cargas de inteligencia artificial persistentes, con disponibilidad para noviembre de 2026. Su enfoque incluye agentes locales que pueden mantenerse activos durante periodos prolongados dadas las soluciones termicas mas robustas del formato de escritorio compacto, para inferencia hibrida, suenan como una buena alternativa.
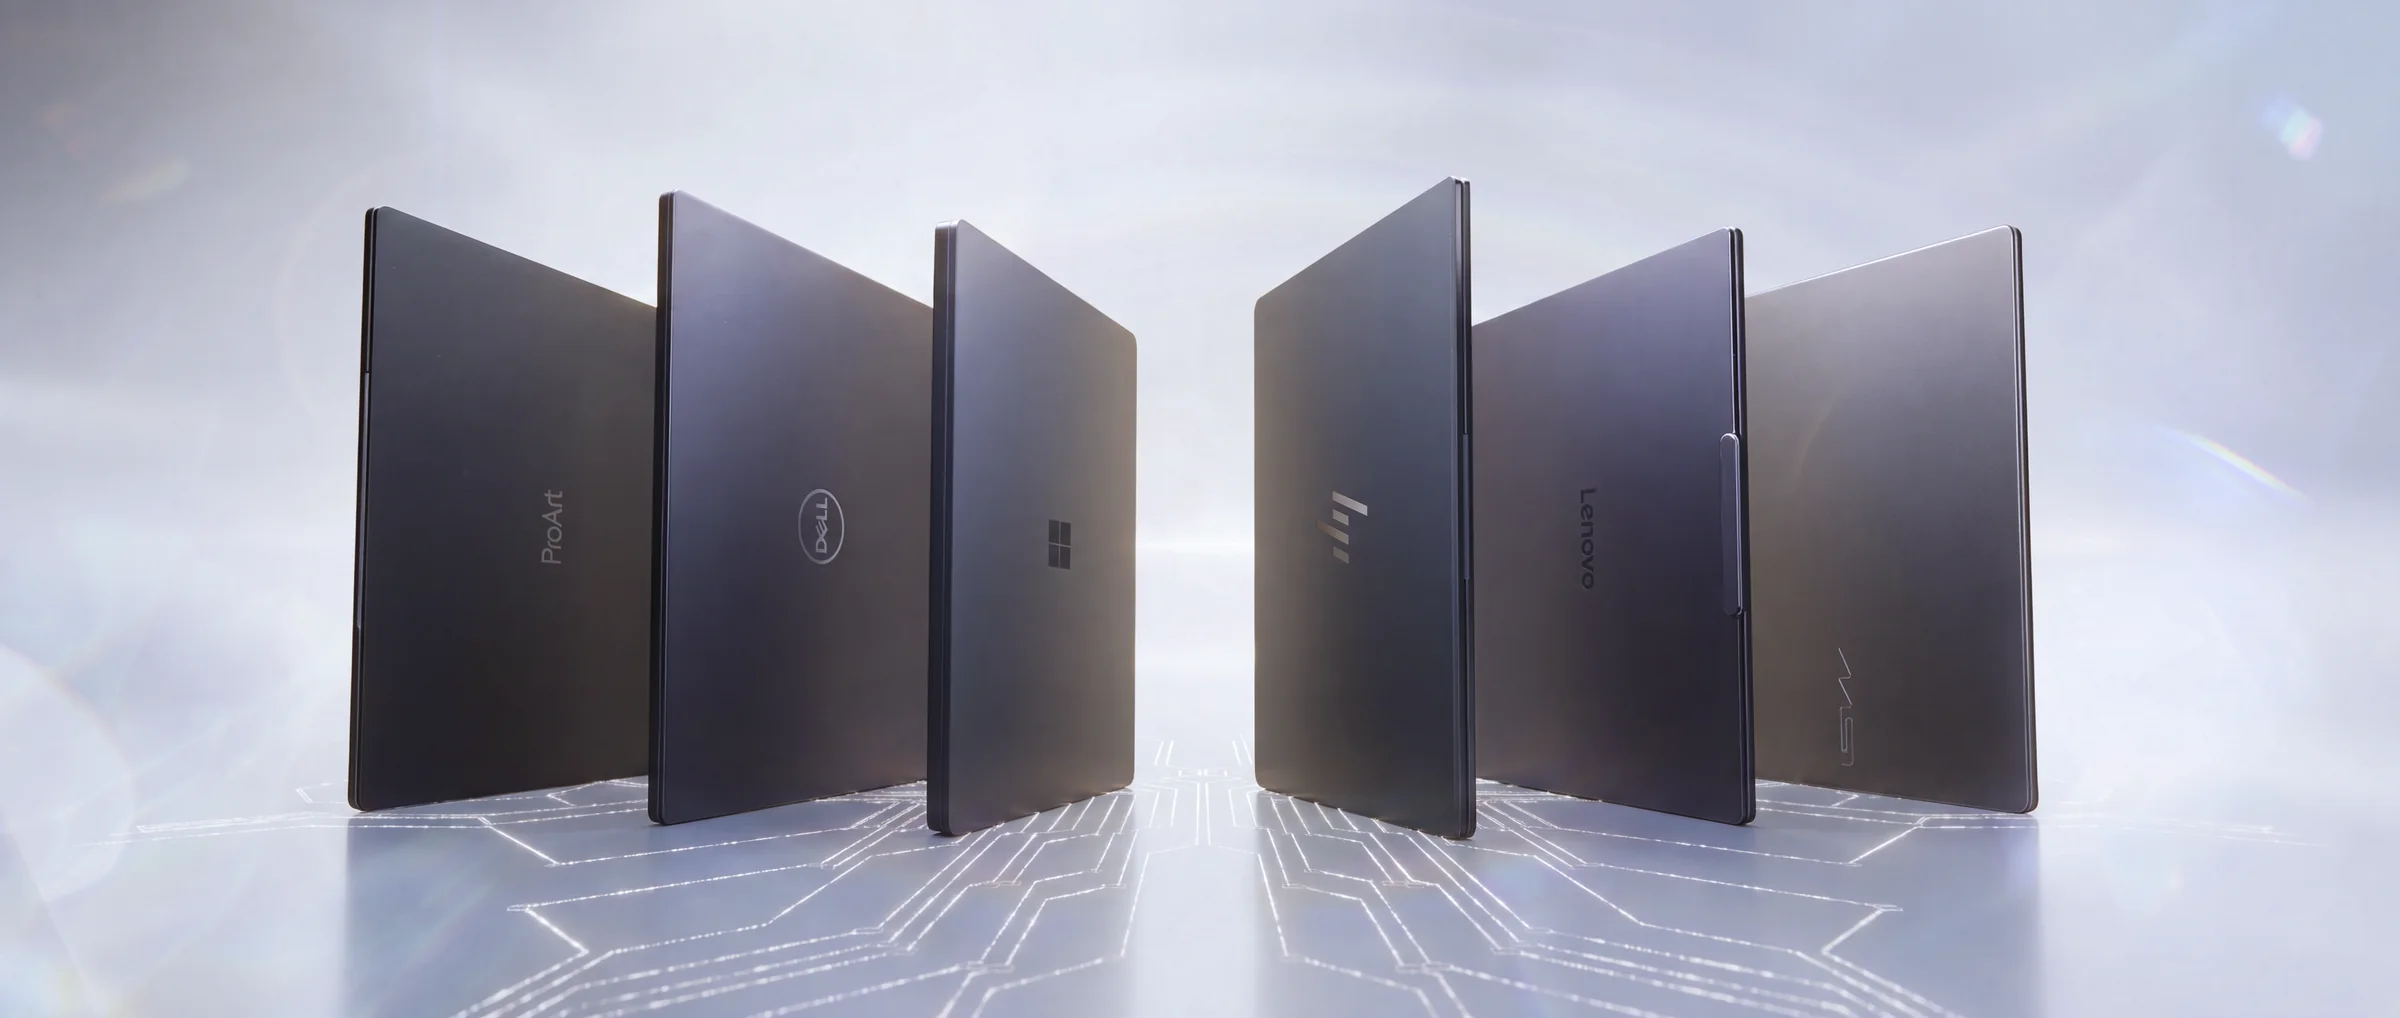
NVIDIA ya no quiere vender solamente el GPU
RTX Spark representa un movimiento importante (y quizas peligroso) dentro de la evolución del mercado de PC, dado que hasta ahora, NVIDIA participaba solo mediante GPUs dedicadas, mientras que fabricantes como Intel y AMD suministraban el procesador principal. Con N1X, la compañía busca controlar toda la plataforma, incluyendo CPU, GPU, interconexión, herramientas de inteligencia artificial y parte del ecosistema de software. Dicha estrategia entra en competencia directa con otros sistemas basados en memoria unificada, como los procesadores Apple Silicon, pero trasladada al ecosistema Windows y acompañada por las tecnologías RTX y CUDA de NVIDIA.
El verdadero reto será demostrar que RTX Spark puede equilibrar esas características en productos exitosamente comerciales, especialmente cuando se utilicen aplicaciones reales durante periodos prolongados y más allá de sus cifras de rendimiento, RTX Spark muestra hacia dónde quiere dirigir NVIDIA el mercado de computadoras personales: equipos que no solamente ejecuten programas tradicionales, sino que también dispongan de suficiente capacidad de cómputo y memoria para mantener modelos y agentes de inteligencia artificial funcionando localmente, pero que no sean modulares, para poder vender sistemas completos cada que se requiera alguna actualización, y es esto lo que considero es el punto mas peligroso de que se adopte de forma masiva, el final de la modularidad, como discutibles ventajas tecnológicas que maquillan una realidad comercial sin muchos escrúpulos.
Galería de imágenes
rtx SPARK
Etiquetas
- #GPU
- #Keynote (NVIDIA)
- #Nvidia
- #Laptops
- #Inteligencia Artificial
- #Memoria
- #RTX
Artículos relacionados
 Inteligencia Artificial
AMD lleva IA local a Hollywood: un agente en Slack ya ayuda a coordinar hasta nueve producciones
- 8 min
 Inteligencia Artificial
Radeon AI PRO R9700: Linux puede sacar hasta 60% más throughput que nuestro stack en Windows
- 10 min
 Inteligencia Artificial
AMD EPYC Venice y la IA agéntica: el CPU recupera protagonismo en los datacenters del futuro
- 9 min
Comentarios
Aún no hay comentarios. ¡Sé el primero en comentar!