Radeon AI PRO R9700: Linux puede sacar hasta 60% más throughput que nuestro stack en Windows
- Por Ed Corsa
- 10 min de lectura
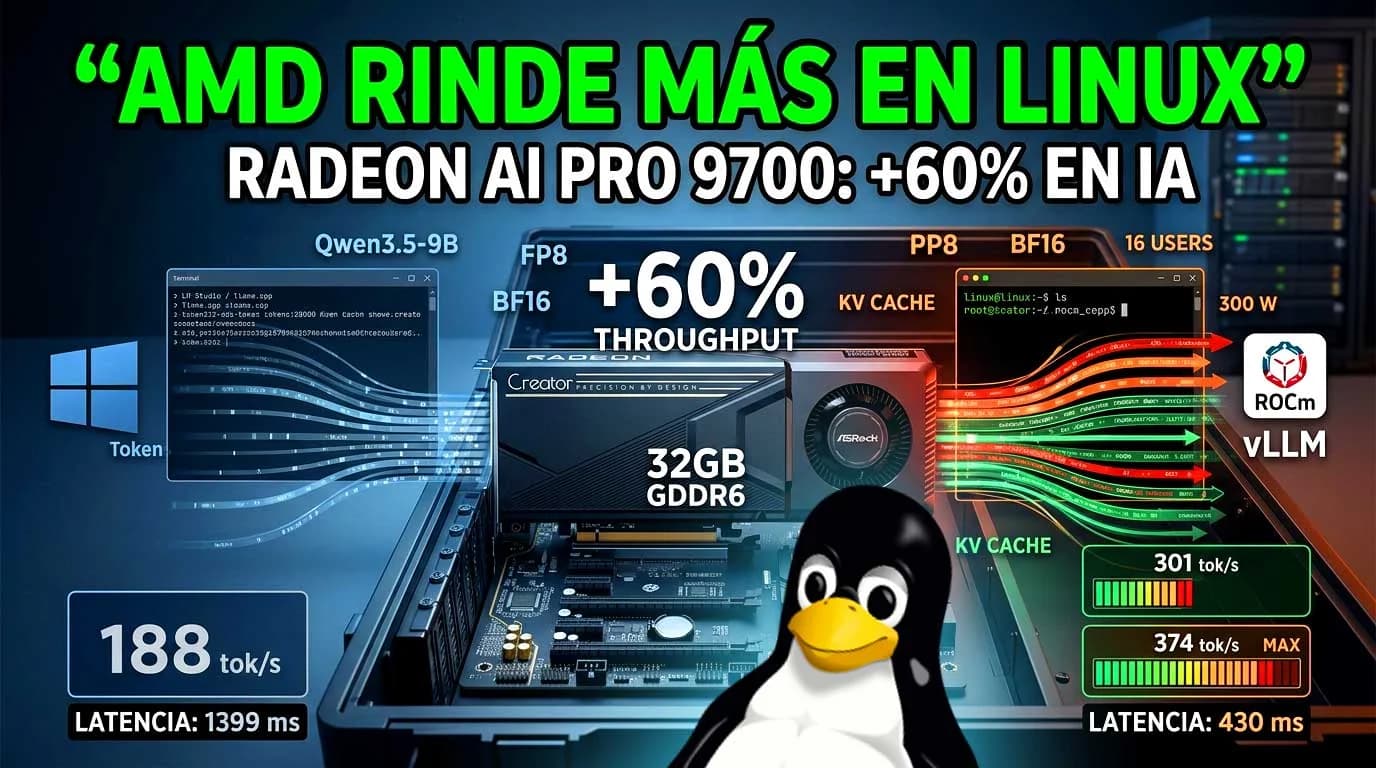
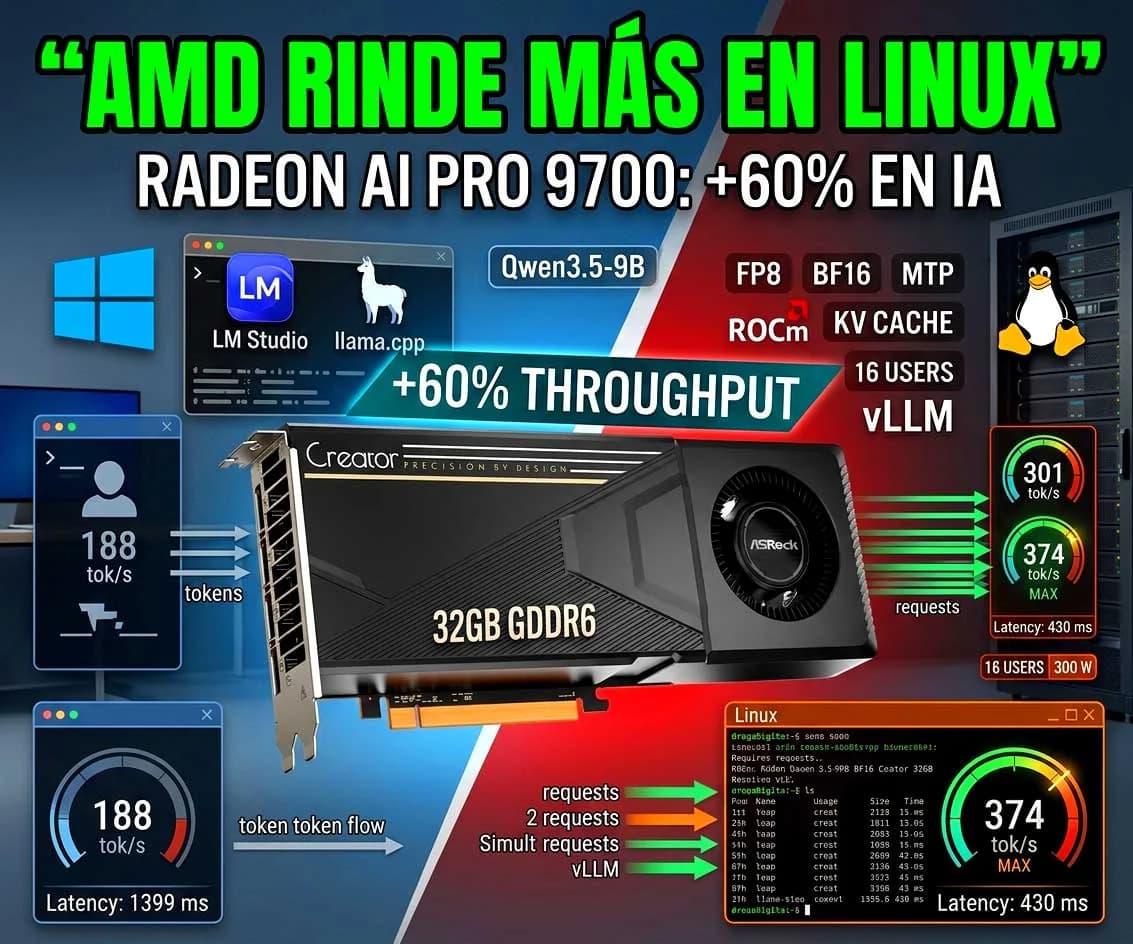
La Radeon AI PRO R9700 funciona en Windows, pero Linux libera un stack de inferencia mucho más completo. En nuestras pruebas con Qwen3.5-9B, vLLM + ROCm alcanzó 301 tokens/s frente a 188 tokens/s de llama.cpp en BF16 bajo alta concurrencia.
Existe una idea que todavía escuchamos bastante cuando hablamos de inteligencia artificial local:
“AMD no sirve para IA”.
Hace algunos años era fácil entender de dónde venía esa percepción. CUDA tenía (y sigue teniendo) un ecosistema enorme, mientras que utilizar una Radeon para cosas relativamente comunes podía convertirse rápidamente en una colección de repositorios, dependencias y plegarias a cualquier deidad actual o del panteon de tu preferencia para resolverlo...
Pero las cosas han cambiado bastante.
Con base al reciente video que publicó mi colega Benjamín Hurtado en nuestro canal de youtube, les traigo este articulo donde la Radeon AI PRO R9700 que se puso a proeba, demuestra que AMD ya tiene hardware muy interesante para inferencia local. Lo importante, sin embargo, es entender que Windows tampoco es necesariamente el mejor lugar para aprovecharlo. y eso podría traer a la mesa un pequeño problema de adopción por plataforma, pero tambien una ventaja dificil de ignorar.
Después de probar Qwen3.5-9B bajo diferentes niveles de concurrencia, nuestra conclusión es bastante sencilla: si la R9700 va a utilizarse seriamente para inferencia, nosotros instalaríamos Linux, porque hoy el ecosistema profesional alrededor de ROCm, vLLM y varias de las optimizaciones más interesantes está claramente más desarrollado en Linux y nuestros números reflejan precisamente esa diferencia.
La Radeon AI PRO R9700 tampoco es simplemente una GPU gaming con más memoria
Para las pruebas se ha utilizado la ASRock Radeon AI PRO R9700 Creator 32GB, una tarjeta profesional basada en RDNA 4, en ella Tenemos 64 Compute Units, 4,096 Stream Processors y 128 aceleradores de IA de segunda generación, acompañados por 32 GB de memoria GDDR6 sobre un bus de 256 bits, AMD señala hasta 2,920 MHz de Boost, 2,350 MHz de Game Clock y 640 GB/s de ancho de banda de memoria. También ofrece rendimiento máximo teórico de 191 TFLOPS en operaciones matriciales FP16 y 383 TFLOPS en FP8.
La variante de ASRock utiliza un diseño de dos slots con blower, cámara de vapor, backplate metálico y Honeywell PTM7950. El blower tampoco está ahí únicamente para hacer ruido: expulsa el aire directamente fuera del gabinete y facilita instalar varias GPUs juntas dentro de una workstation.
AMD RADEON AI PRO R9700 CREATOR 32GB
| Especificación | Radeon AI PRO R9700 Creator |
|---|---|
| Arquitectura | RDNA 4 |
| Compute Units | 64 |
| Stream Processors | 4,096 |
| Aceleradores IA | 128, 2ª generación |
| RT Accelerators | 64, 3ª generación |
| VRAM | 32 GB GDDR6 |
| Bus | 256-bit |
| Velocidad memoria | 20 Gbps |
| Ancho de banda | 640 GB/s |
| Infinity Cache | 64 MB |
| Boost Clock | Hasta 2,920 MHz |
| Game Clock | 2,350 MHz |
| FP16 Matrix | Hasta 191 TFLOPS |
| FP8 Matrix | Hasta 383 TFLOPS |
| PCIe | 5.0 x16 |
| TBP | 300 W |
| Alimentación | 1× 12V-2x6 |
| Salidas | 4× DisplayPort 2.1a |
| Diseño ASRock | Blower, 2 slots |
| Cámara de vapor | Sí |
| Material térmico | Honeywell PTM7950 |
| ECC | Sí, Linux únicamente |
AMD la lanzó con un MSRP de $1,299 dólares, colocando 32 GB de VRAM en una zona de precio bastante interesante para IA local. AMD incluso la promociona específicamente como una alternativa de alto valor para cargas donde la cantidad de memoria importa tanto como el rendimiento bruto.
Windows funciona. Pero Linux nos deja usar mejores herramientas
En Microsoft Windows podemos utilizar herramientas extremadamente cómodas como LM Studio, Ollama o soluciones basadas en llama.cpp y para una persona utilizando un modelo local desde su escritorio, llama.cpp sigue siendo una opción excelente ya que es relativamente sencillo, soporta una cantidad enorme de modelos y formatos GGUF y puede ofrecer muy buen rendimiento con una sola solicitud.
Pero eso tampoco es necesariamente lo que queremos de una GPU profesional con 32 GB de VRAM, si nuestra intención es convertir esa workstation en un servidor para varios usuarios, atender muchas solicitudes simultáneamente, exponer una API o ejecutar cargas de inferencia de manera continua, entramos en el territorio de vLLM, que está diseñado precisamente alrededor de "serving de alto throughput": utiliza PagedAttention para gestionar de manera eficiente el KV cache, continuous batching para agrupar solicitudes y soporta paralelismo, quantization y speculative decoding.
Y aquí aparece la diferencia fundamental:
vLLM no soporta Windows de forma nativa, su plataforma oficial para GPU requiere Linux. En Windows podemos recurrir a WSL o forks mantenidos por la comunidad, pero el camino principal sigue siendo Linux.
ROCm 10 refuerza exactamente la misma situación: AMD valida actualmente vLLM y SGLang sobre Linux para GPUs gfx1201, arquitectura que incluye precisamente a la Radeon AI PRO R9700.
Así que si nuestro objetivo es IA profesional con AMD, la pregunta tampoco es únicamente cuál sistema operativo consume menos recursos. Linux nos abre un stack que en Windows simplemente todavía no está disponible de la misma forma.
Nuestra prueba: Qwen3.5-9B, llama.cpp contra vLLM
Utilizamos una workstation con:
-
Ryzen Threadripper 7980X.
-
128 GB de memoria RAM.
-
Radeon AI PRO R9700 Creator 32GB.
-
Qwen3.5-9B.
-
Una, cuatro, ocho y 16 sesiones simultáneas.
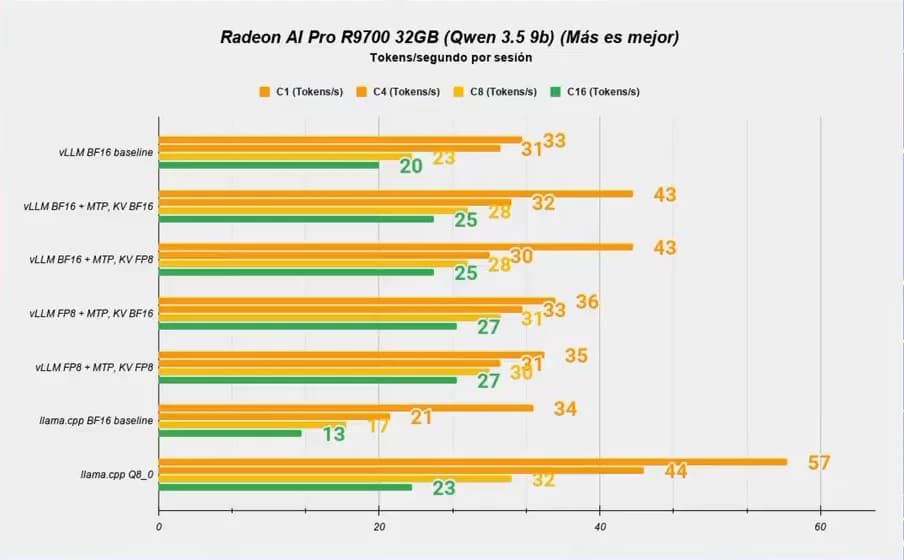
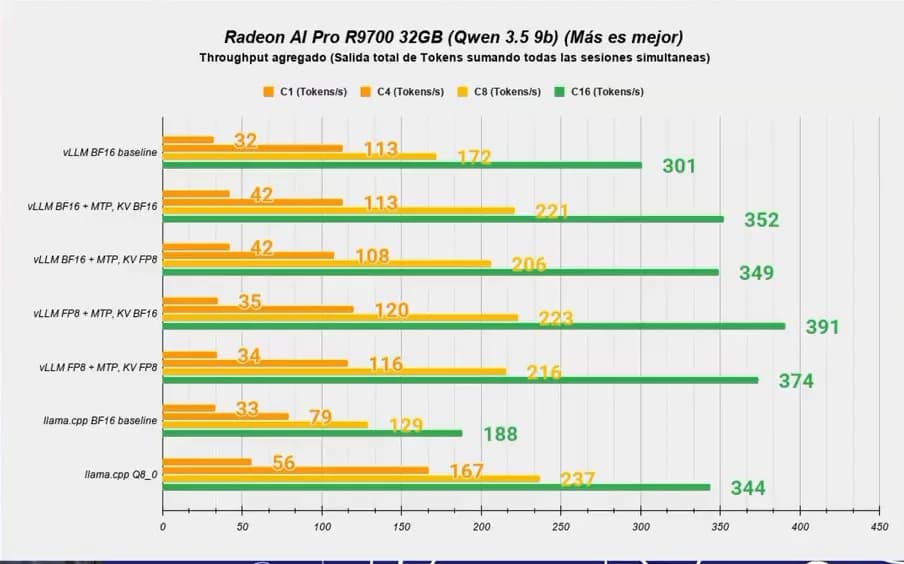
Probamos diferentes precisiones y configuraciones de KV cache, comparando nuestro stack de llama.cpp en Windows con vLLM sobre Linux, aquí la métrica más interesante es el throughput agregado: cuántos tokens puede producir en total el sistema sumando todas las solicitudes concurrentes, con una sola sesión, llama.cpp funciona extraordinariamente bien.
La variante cuantizada Q8 llegó a aproximadamente 56-57 tokens por segundo, encabezando esa parte de la prueba, pero conforme empezamos a agregar usuarios, el comportamiento cambia.
En la comparación directamente equivalente en BF16, llama.cpp alcanzó aproximadamente:
188 tokens/s de throughput agregado
mientras que vLLM llegó a:
301 tokens/s.
Eso representa aproximadamente 60% más throughput en vLLM cuando llegamos a 16 sesiones simultáneas, no, no estamos hablando de una pequeña diferencia dentro del margen de error estamos hablando de atender bastante más trabajo con exactamente la misma GPU.
Con FP8 y MTP llegamos hasta 374 tokens por segundo
Y aquí Linux empieza a resultar todavía más interesante, Qwen3.5 soporta MTP, Multi-Token Prediction, una forma de decodificado especulativo donde el propio modelo puede proponer varios tokens futuros que posteriormente son verificados, vLLM soporta MTP en modelos que incluyen estas cabezas nativas, entre ellos Qwen3.5.
Al utilizar Qwen3.5-9B FP8 + MTP + KV cache FP8 nuestra R9700 alcanzó aproximadamente: 374 tokens/s de throughput agregado.
Eso tampoco es comparable directamente como si fuera BF16 contra BF16, porque estamos utilizando otra precisión y optimizaciones adicionales pero justamente ahí está el punto, En Linux tenemos acceso a esas optimizaciones.
Se los digo, no conseguimos una GPU de IA para demostrar que dos sistemas operativos ejecutan exactamente el mismo software, sino para utilizar el mejor stack disponible y actualmente, en AMD, ese stack está en Linux.
La latencia también cambia muchísimo
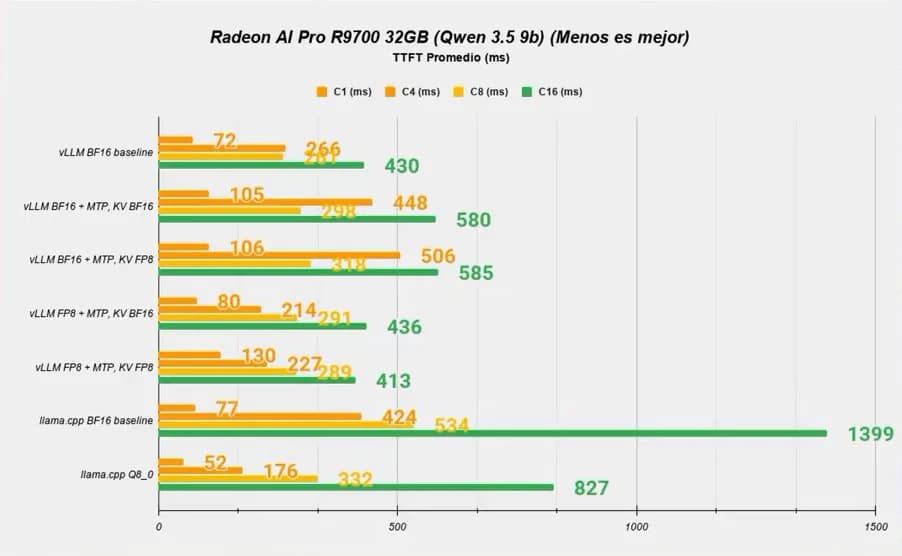
Otro resultado bastante revelador fue el Time To First Token, TTFT, esta métrica mide cuánto tiempo transcurre desde que enviamos nuestra solicitud hasta que el modelo comienza a respondernos.
En BF16 con 16 sesiones concurrentes medimos aproximadamente: vLLM: 430 ms
frente a: llama.cpp: 1,399 ms.
vLLM redujo la latencia alrededor de 69%, o dicho de otra forma, comenzó a producir la respuesta aproximadamente 3.25 veces antes, algo mucho más importante en un sistema compartido que conseguir un par de tokens adicionales a velocidad máxima. Cuando tenemos múltiples usuarios enviando consultas largas, una aplicación donde el modelo tarda casi segundo y medio en empezar a responder comienza a sentirse notablemente diferente frente a otra donde tarda menos de medio segundo.
32 GB permiten hacer cosas muy interesantes con el KV cache
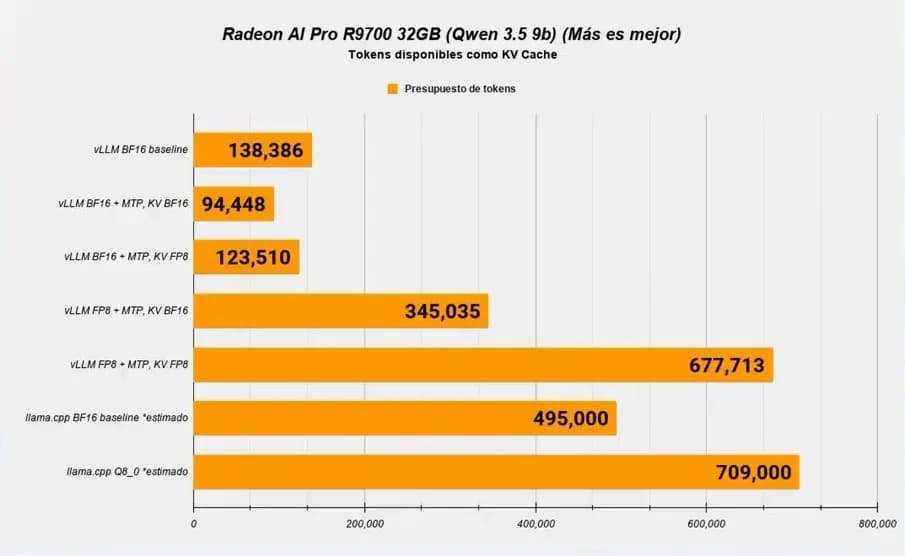
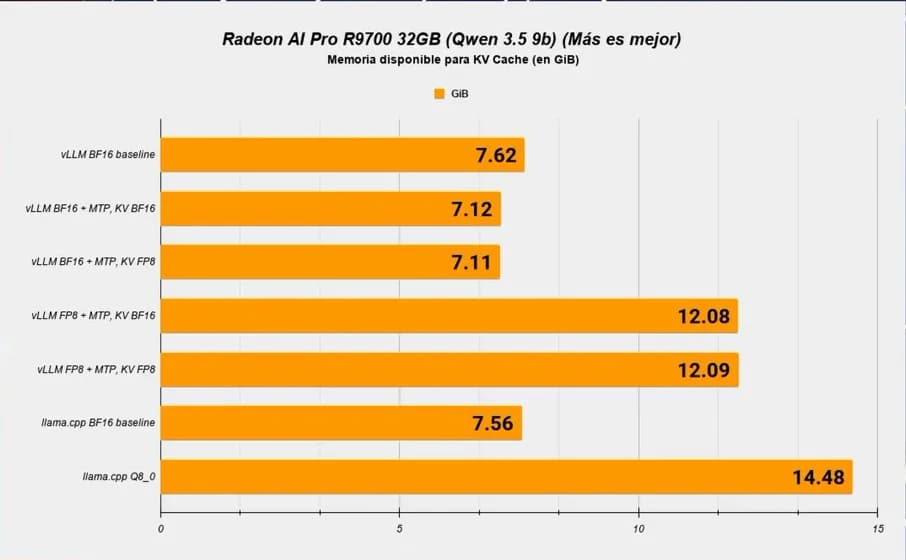
La memoria tampoco sirve únicamente para cargar modelos más grandes. En inferencia concurrente, una cantidad considerable de VRAM termina dedicada al KV cache, donde se almacena información necesaria para mantener el contexto de cada conversación.
Más usuarios, conversaciones más largas y ventanas de contexto mayores significan más memoria utilizada. èsta es precisamente una de las áreas donde vLLM resulta especialmente fuerte gracias a PagedAttention y su manejo de memoria, además podemos cuantizar el KV cache.
En nuestra prueba utilizamos FP8, reduciendo significativamente su consumo de memoria y permitiendo acomodar más contexto y más sesiones simultáneamente.
vLLM también está incorporando tecnologías como TurboQuant, diseñada específicamente para comprimir el KV cache. Sus presets actuales permiten reducciones aproximadas desde 2.6x hasta casi 5x dependiendo de cuánto estemos dispuestos a comprometer calidad.
Esto puede resultar particularmente interesante con arquitecturas donde el KV cache crece muy rápidamente.
Y nuevamente estamos hablando de tecnologías desarrolladas dentro de un ecosistema abierto que no depende exclusivamente de una implementación propietaria de NVIDIA.
RESULTADOS CLAVE DE NUESTRAS PRUEBAS
| Escenario | Resultado |
|---|---|
| llama.cpp Q8, una sesión | ~56–57 tok/s |
| llama.cpp BF16, 16 sesiones | 188 tok/s agregados |
| vLLM BF16, 16 sesiones | 301 tok/s agregados |
| Ventaja vLLM BF16 | ~60% |
| vLLM FP8 + MTP + KV FP8 | hasta 374 tok/s agregados |
| TTFT llama.cpp BF16, 16 sesiones | 1,399 ms |
| TTFT vLLM BF16, 16 sesiones | 430 ms |
| Reducción de TTFT | ~69% |
¿Entonces AMD puede reemplazar a NVIDIA para IA local?
En algunos escenarios, claro que si!, en otros, todavía no. NVIDIA continúa teniendo una enorme ventaja histórica en software alrededor de CUDA, así como aplicaciones profesionales construidas específicamente para su ecosistema.
Si tenemos un programa que exige CUDA o utiliza una extensión disponible únicamente para NVIDIA, una Radeon tampoco va a solucionar mágicamente ese problema, pero ésa ya no es toda la historia de la IA, con proyectos como PyTorch, vLLM, llama.cpp, SGLang, Hugging Face y ROCm se están construyendo caminos cada vez menos dependientes de una sola marca, y la propia documentación actual de ROCm 10 incluye soporte validado para PyTorch, JAX, vLLM, SGLang, TensorFlow, MIGraphX y ONNX Runtime, aunque el soporte concreto sigue dependiendo de GPU y sistema operativo.
Y lo mejor es que la R9700 ya está oficialmente soportada en ROCm como GPU
Seamos concisos, la conversación ya no debería ser “AMD funciona o no funciona para IA” sino que debe ser: “¿mi workload funciona bien dentro del stack ROCm que quiero utilizar?”
Porque cuando la respuesta es sí, 32 GB de VRAM por un MSRP original de $1,299 pueden cambiar bastante la ecuación costo-beneficio.
Incluso AMD trata Linux como la plataforma completa
Hay un detalle pequeño pero bastante revelador en las propias especificaciones de la R9700, la tarjeta soporta memoria ECC, pero AMD especifica:
ECC: Linux Only.
Para gaming esto nos daría exactamente igual pero para una tarjeta profesional utilizada durante horas procesando modelos, simulaciones o datasets, ya no tanto, eso es otra señal de dónde AMD está concentrando actualmente las capacidades profesionales y de cómputo de esta GPU y aunque Windows sigue teniendo soporte oficial, drivers profesionales y aplicaciones de creación, ya no es la unica opcion ni la mejor, si hablamos específicamente de inferencias de IA, serving y despliegues profesionales, Linux es donde encontramos el ecosistema más completo.
Nuestra recomendación es: si la R9700 es para IA, instalen Linux
Después de estas pruebas, yo tampoco compraría una Radeon AI PRO R9700 para utilizarla exclusivamente en Windows si mi objetivo principal fuera inteligencia artificial. Para experimentar con modelos desde el escritorio, utilizar LM Studio o correr una conversación individual, Windows funciona perfectamente, pero si estamos construyendo una workstation seria, un servidor de inferencia local, un entorno empresarial privado o una máquina que atenderá múltiples usuarios:
Linux + ROCm + vLLM es actualmente la configuración que elegiríamos.
Con ese escenario la R9700 empieza a ser bastante más interesante de lo que su reputación inicial podría sugerir (Radeon, coff coff...), ya que tenemos 32 GB de VRAM, posibilidad de configuraciones multi-GPU, soporte FP8, un ecosistema que está avanzando muy rápidamente y software abierto que disminuye nuestra dependencia de una plataforma específica.
NVIDIA continúa siendo extraordinariamente fuerte, pero en 2026 y en adelante “usar IA” ya tampoco significa obligatoriamente “usar CUDA”.
Porque mientras proyectos como vLLM y ROCm sigan madurando, una Radeon puede pasar de ser la alternativa exótica a convertirse, para determinados workloads, en el reemplazo completo que tiene más sentido por costo, memoria y libertad de plataforma. Sólo hay que olvidarnos de Windows cuando sea para trabajar en serio.
FUENTES
AMD Radeon AI PRO R9700 — especificaciones oficiales
https://www.amd.com/en/products/graphics/workstations/radeon-ai-pro/ai-9000-series/amd-radeon-ai-pro-r9700.html
ASRock Radeon AI PRO R9700 Creator 32GB
https://www.asrock.com/Graphics-Card/AMD/Radeon%20AI%20PRO%20R9700%20Creator%2032GB/
Linux + AMD = 😍 Lo ponemos a prueba en IA! Radeon AI PRO R9700 32GB llama.cpp vs vLLM - DrogaDigital
https://youtu.be/c21YVN8HpNw
Galería de imágenes
Linux + AMD 😍 Lo ponemos a prueba en IA! Radeon AI PRO R9700 32GB llama.cpp vs vLLM DrogaDigital.mp4 snapshot 09.49.789
Linux + AMD 😍 Lo ponemos a prueba en IA! Radeon AI PRO R9700 32GB llama.cpp vs vLLM DrogaDigital.mp4 snapshot 09.19.759
Linux + AMD 😍 Lo ponemos a prueba en IA! Radeon AI PRO R9700 32GB llama.cpp vs vLLM DrogaDigital.mp4 snapshot 10.33.934
Linux + AMD 😍 Lo ponemos a prueba en IA! Radeon AI PRO R9700 32GB llama.cpp vs vLLM DrogaDigital.mp4 snapshot 05.07.507
Linux + AMD 😍 Lo ponemos a prueba en IA! Radeon AI PRO R9700 32GB llama.cpp vs vLLM DrogaDigital.mp4 snapshot 09.26.018
RADEON AI PRO 9700 windows vs linux SQARED
linux vs windows radeon ai pro title
Etiquetas
- #AMD
- #Radeon
- #Nvidia
- #Inteligencia Artificial
- #RTX
- #Linux
Artículos relacionados
 Inteligencia Artificial
AMD EPYC Venice y la IA agéntica: el CPU recupera protagonismo en los datacenters del futuro
- 9 min
 Inteligencia Artificial
El colapso del cerebro humano ante la IA generativa ... Y todo para producir 50 veces más para que nadie escuche
- 5 min
Comentarios
Aún no hay comentarios. ¡Sé el primero en comentar!