Las computadoras se van a equivocar cada vez MAS, si estudias Ciencias de la computación esto te interesa
- Por Ed Corsa
- 6 min de lectura
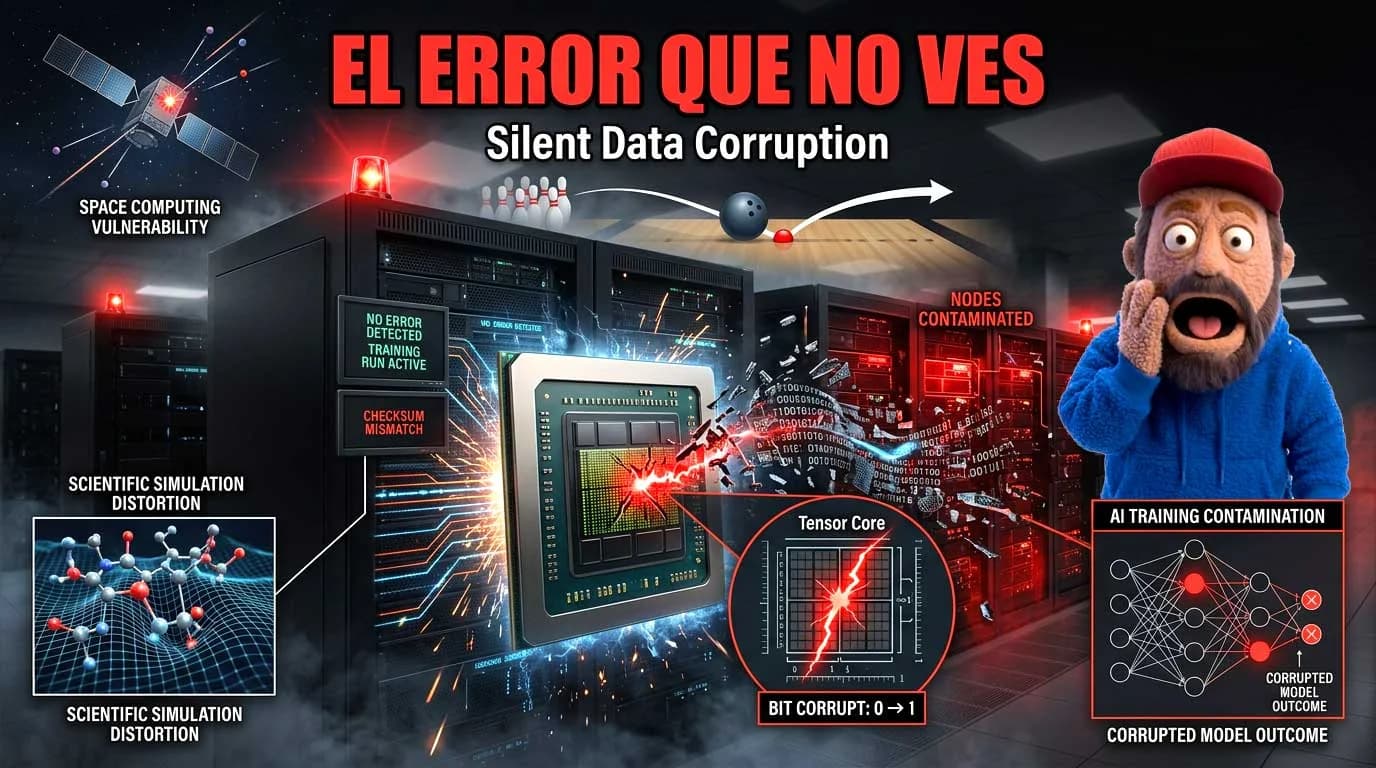
Las Corrupciones Silenciosa de Datos pueden convertirse en un problema cada vez más relevante conforme crecen los sistemas de IA, HPC y computación espacial. El futuro podría requerir software capaz de detectar errores silenciosos y continuar funcionando sin asumir que cada resultado producido por el hardware es correcto.
La recomendación que le haría seriamente a alguien que esté estudiando Ciencias de la computación (Computer Science) y todavía no sepa de qué hacer su tesis sería: échale un ojo a los Silent Data Corruptions y a la tolerancia algorítmica a fallos, no porque dentro de cinco años todas nuestras computadoras vayan a empezar a sumar mal o a cometer errores aleatorios de aritmética (eso ya lo hacen actualmente los LLMs y se esta trabajando por mitigarlo), sino porque llevamos décadas disfrutando de una abstracción extraordinariamente cómoda: "el hardware funciona"
Podemos tener bugs en nuestro código, drivers rotos, memoria insuficiente o un sistema operativo haciendo tonterías, pero normalmente asumimos que si pedimos al procesador multiplicar dos números, el resultado de esa operación será correcto, una corrupcion silenciosa de datos (Silent Data Corruption, SDC), rompe precisamente esa confianza. El sistema no se apaga, tampoco necesariamente aparece un error, el programa puede continuar funcionando perfectamente y simplemente obtenemos un dato incorrecto.
Google lo considera suficientemente real como para que su infraestructura permita reportar explícitamente un host por SILENT_DATA_CORRUPTION: la instancia continúa funcionando mientras los datos están siendo corrompidos y cuando hablamos de una sola computadora no parece demasiado problema, pero cuando hablamos de decenas o cientos de miles de aceleradores trabajando sobre el mismo problema, la cosa cambia.
Un GPU que se equivoca puede ser peor que uno que muere
Un GPU muerto resulta bastante sencillo de entender, deja de responder, genera un error, lo retiramos del cluster y continuamos; un GPU que funciona pero ocasionalmente produce resultados incorrectos es otra historia.
Imaginemos un Tensor Core defectuoso que introduce una corrupción pequeña dentro de un entrenamiento de IA. Quizá una operación incorrecta no haga absolutamente nada perceptible, después de todo estos workloads ya trabajan con ruido numérico, aproximaciones y enormes cantidades de datos, pero si ese mismo hardware introduce el mismo tipo de error una y otra vez, el problema puede propagarse.
Es un poco como darle un poco de efecto a una bola de boliche, al principio apenas cambia la trayectoria, pero déjala avanzar suficiente distancia y termina completamente en otro lado.
Esto tampoco es una preocupación puramente hipotética de un futuro que jamas llegará. Google señalaba este mismo año que, cuando los clusters de IA crecen hacia cientos de miles de aceleradores, la variación estadística del hardware empieza a convertirse por sí misma en una restricción de confiabilidad.
No vamos a solucionar todo poniendo más ECC
Aquí aparece la parte interesante para alguien de Ciencias de la computación, obviamente podemos robustecer el hardware, ya tenemos ECC, redundancia, diagnósticos, mejores circuitos, replay de operaciones, memoria protegida y montones de técnicas que utilizamos precisamente para impedir que un bit rebelde destruya un cálculo, pero proteger absolutamente todo cuesta silicio, energía, complejidad y rendimiento.
Investigadores de NVIDIA han estudiado este problema directamente en memoria de GPUs utilizando haces de neutrones de alta energía y señalan que proteger interfaces DRAM con grandes anchos de banda puede resultar caro y complicado. La solución tampoco consiste en construir hardware indestructible, sino en encontrar mejores formas de detección y corrección, ahí es donde entra el Algorithm-Based Fault Tolerance.
En lugar de preguntarnos solamente: “¿Cómo evitamos que el hardware falle?” también podemos preguntar: “¿Cómo diseñamos el algoritmo para darse cuenta cuando algo huele mal?”
Alan Turing ya tenía este problema
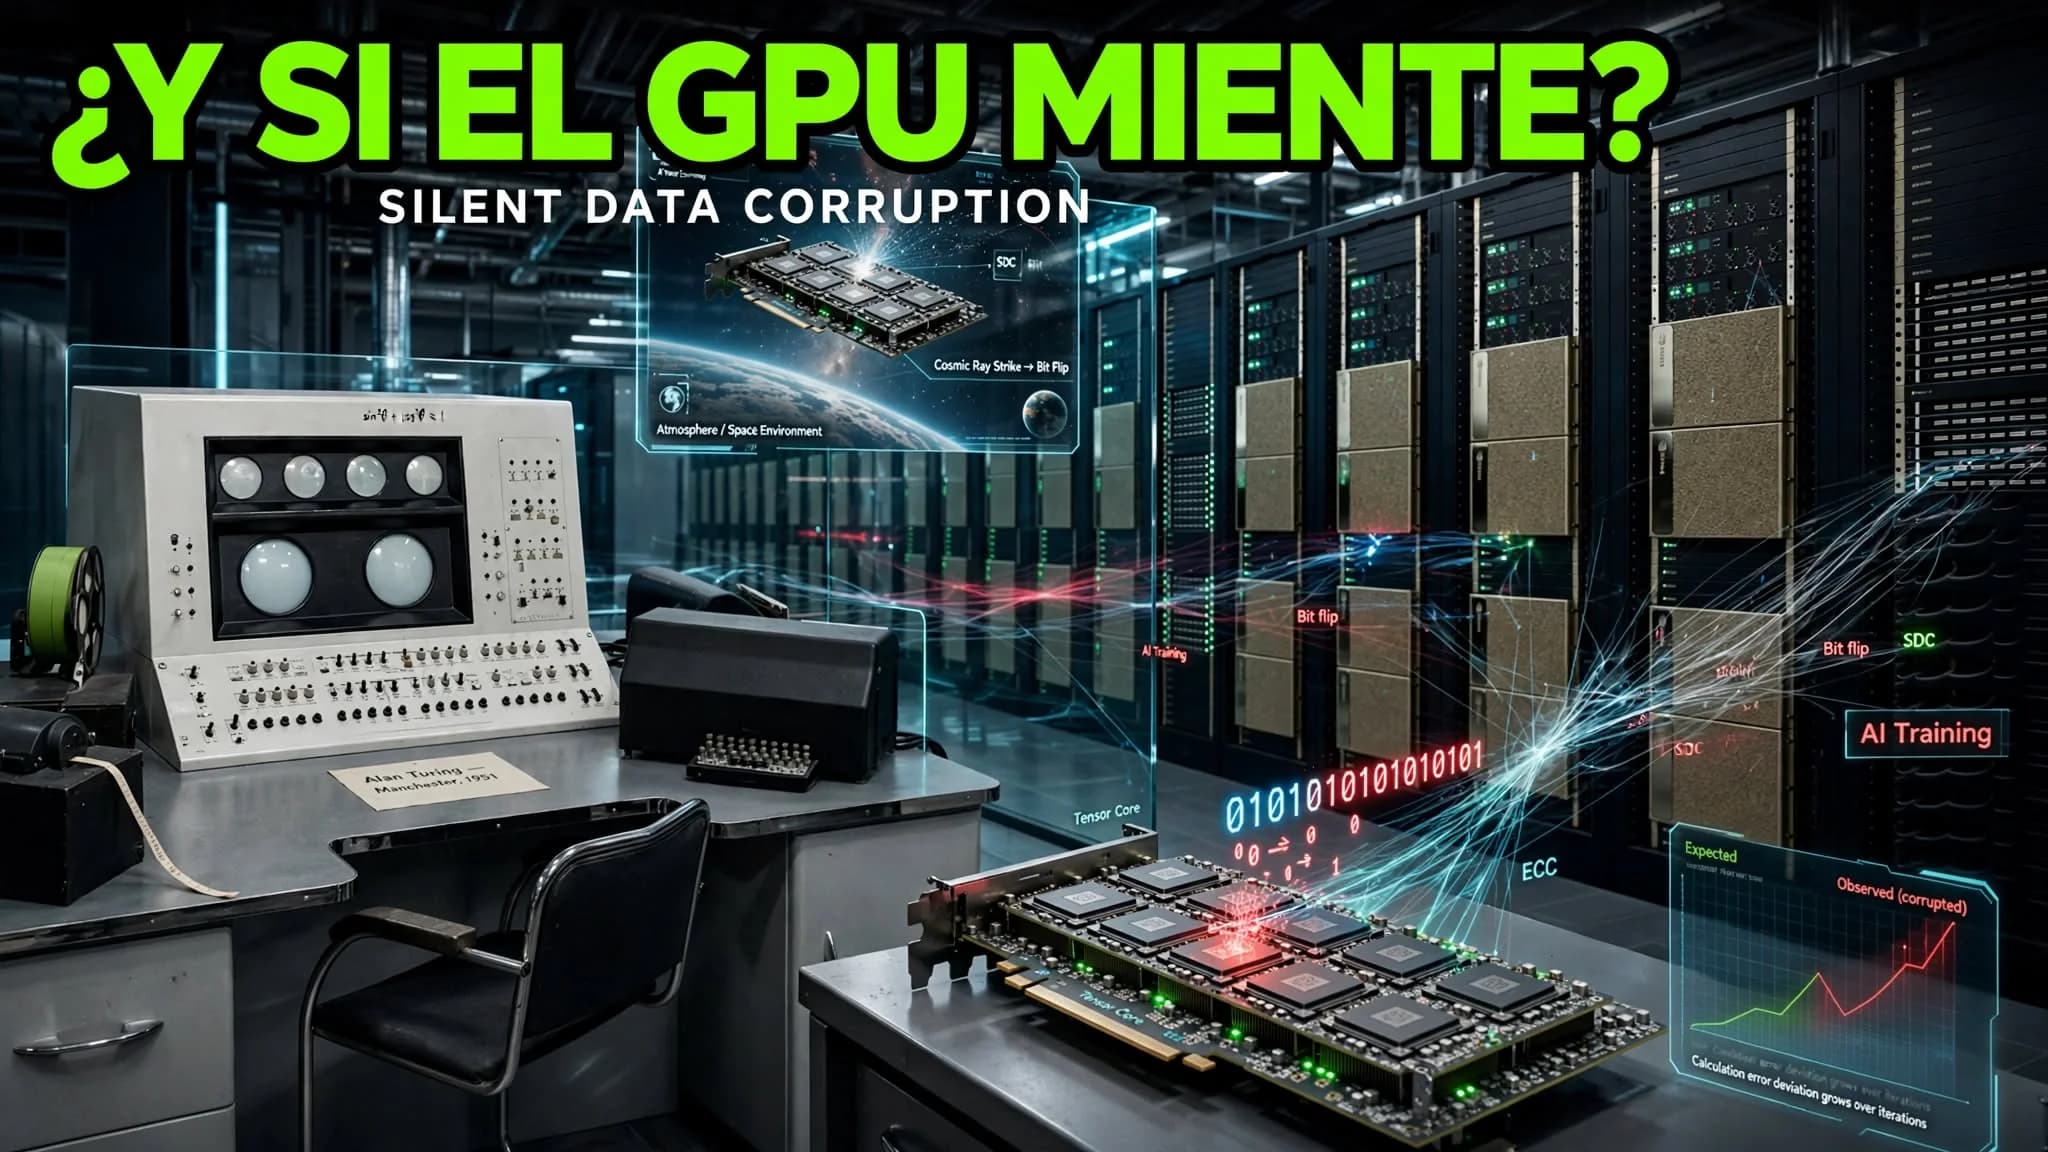
Me encanta es que esta idea parece futurista pero en realidad nos regresa casi al principio de la computación. En el manual que Alan Turing escribió para la computadora Ferranti Mark I, dedica una sección completa a los errores intermitentes, describiéndolos como uno de los problemas más serios y exasperantes de la máquina, entre sus recomendaciones había algo maravilloso: buscar identidades matemáticas que permitieran comprobar los resultados durante el propio cálculo.
Su ejemplo era básicamente éste:
Si ya calculaste seno y coseno de un ángulo, suma sus cuadrados y comprueba que el resultado siga suficientemente cerca de uno, si no lo está, hay que detener la máquina, eso es comprobación y tolerancia algorítmica a fallos en 1951.
Durante ya muchos años, décadas incluso, conseguimos hardware tan extraordinariamente confiable que generaciones completas de programadores pudieron olvidarse casi por completo de este problema, pero quizá no podamos seguir haciéndo esto para siempre en el futuro.
Y luego queremos mandar estos chips al espacio...
La situación se vuelve todavía más divertida cuando empezamos a colocar hardware comercial potente fuera de la protección relativamente agradable de la Tierra, el espacio exterior es bastante hostil, partículas energéticas pueden depositar suficiente carga dentro de un semiconductor para provocar un bit flip sin destruir físicamente el dispositivo. La NASA lleva décadas estudiando estos soft errors, mientras que la ESA ha experimentado específicamente con componentes comerciales en órbita porque son más baratos y mucho más potentes que muchos diseños tradicionales endurecidos contra radiación.
También la NASA ha estudiado GPUs comerciales para estas aplicaciones y señala que al reducir voltajes y dimensiones físicas históricamente ha disminuido la carga necesaria para alterar un estado lógico, aunque la relación real en nodos modernos depende enormemente de arquitectura, proceso de manufactura y mecanismos internos de protección.
Y aquí, encima de todo, aparecen además las IA, cómputo de baja precisión y cuantización. Menos bits pueden significar menor consumo, más rendimiento y modelos más pequeños, pero también cambian completamente cómo se comporta una corrupción. La investigación sobre redes cuantizadas ya muestra que diferentes arquitecturas y métodos de entrenamiento pueden tener sensibilidades muy distintas frente a bit flips, y que incluso podemos entrenarlas específicamente para tolerarlos mejor, otra enorme oportunidad para software.
Quizá volvamos a desconfiar de la computadora
No creo que el futuro sea una computadora donde debamos ejecutar cada cálculo tres veces para asegurarnos de que dos resultados coincidan y tampoco creo que mañana nuestras RTX vayan a empezar a cambiar números por deporte, pero la dirección de la industria es bastante clara: más transistores, más aceleradores, clusters más grandes, cálculos más largos, hardware comercial utilizado en ambientes extraños y workloads donde una operación incorrecta puede propagarse muchísimo antes de que alguien se dé cuenta, y esto puede llevar a problemas que pongan en peligro la vida de muchisimas personas.
En esa escala, incluso eventos extremadamente improbables dejan de sentirse tan improbables, por eso creo que resiliencia algorítmica, detección de SDC y fault-tolerant computing pueden convertirse en áreas particularmente interesantes para la siguiente generación de investigadores de Ciencias de la computación.
Durante mucho tiempo programamos como si la máquina fuera una verdad matemática, quizás el futuro requiera algo bastante más parecido a lo que hacía Turing:
“Sí, computadora, ya vi tu resultado, ahora demuéstrame que no te lo inventaste.”
FUENTES CONSULTADAS
Google Cloud, reporte de hosts con Silent Data Corruption
https://docs.cloud.google.com/ai-hypercomputer/docs/manage/report-faulty-host
Google Cloud, confiabilidad de infraestructura GPU a gran escala
https://cloud.google.com/blog/products/compute/a-guide-to-architecting-reliable-gpu-infrastructure
Google, detección de SDC en unidades SIMD
https://patents.google.com/patent/EP4435607A1/en
NVIDIA Research, soft errors en memoria de GPU
https://research.nvidia.com/publication/2022-03_characterizing-and-mitigating-soft-errors-gpu-dram
NVIDIA Research, experimentos con radiación y confiabilidad de GPU
https://research.nvidia.com/publication/2021-05_demystifying-gpu-reliability-comparing-and-combining-beam-experiments-fault
Galería de imágenes
Data corruption
GPU miente Data corruption
Etiquetas
- #Inteligencia Artificial
- #Software
- #Educación
Comentarios
Aún no hay comentarios. ¡Sé el primero en comentar!